要点
- 生成AIは回答するための仕組みとして作られていない西村は、2026年の段階でモデルが進化しても、要約で元の文章にないことが出たり、答えが出ないときに無理やり回答を作ったりすると述べた。生成AIはそれらしく言葉を紡ぐ現象であって確実な回答を作る仕組みではなく、ハルシネーションは構造上の問題なので解消することは基本的にないと説明した。その結果として、架空の判例を裁判所に提出した例や、架空の文献を政府向け報告書に載せて返金になった例が増えていると紹介した。
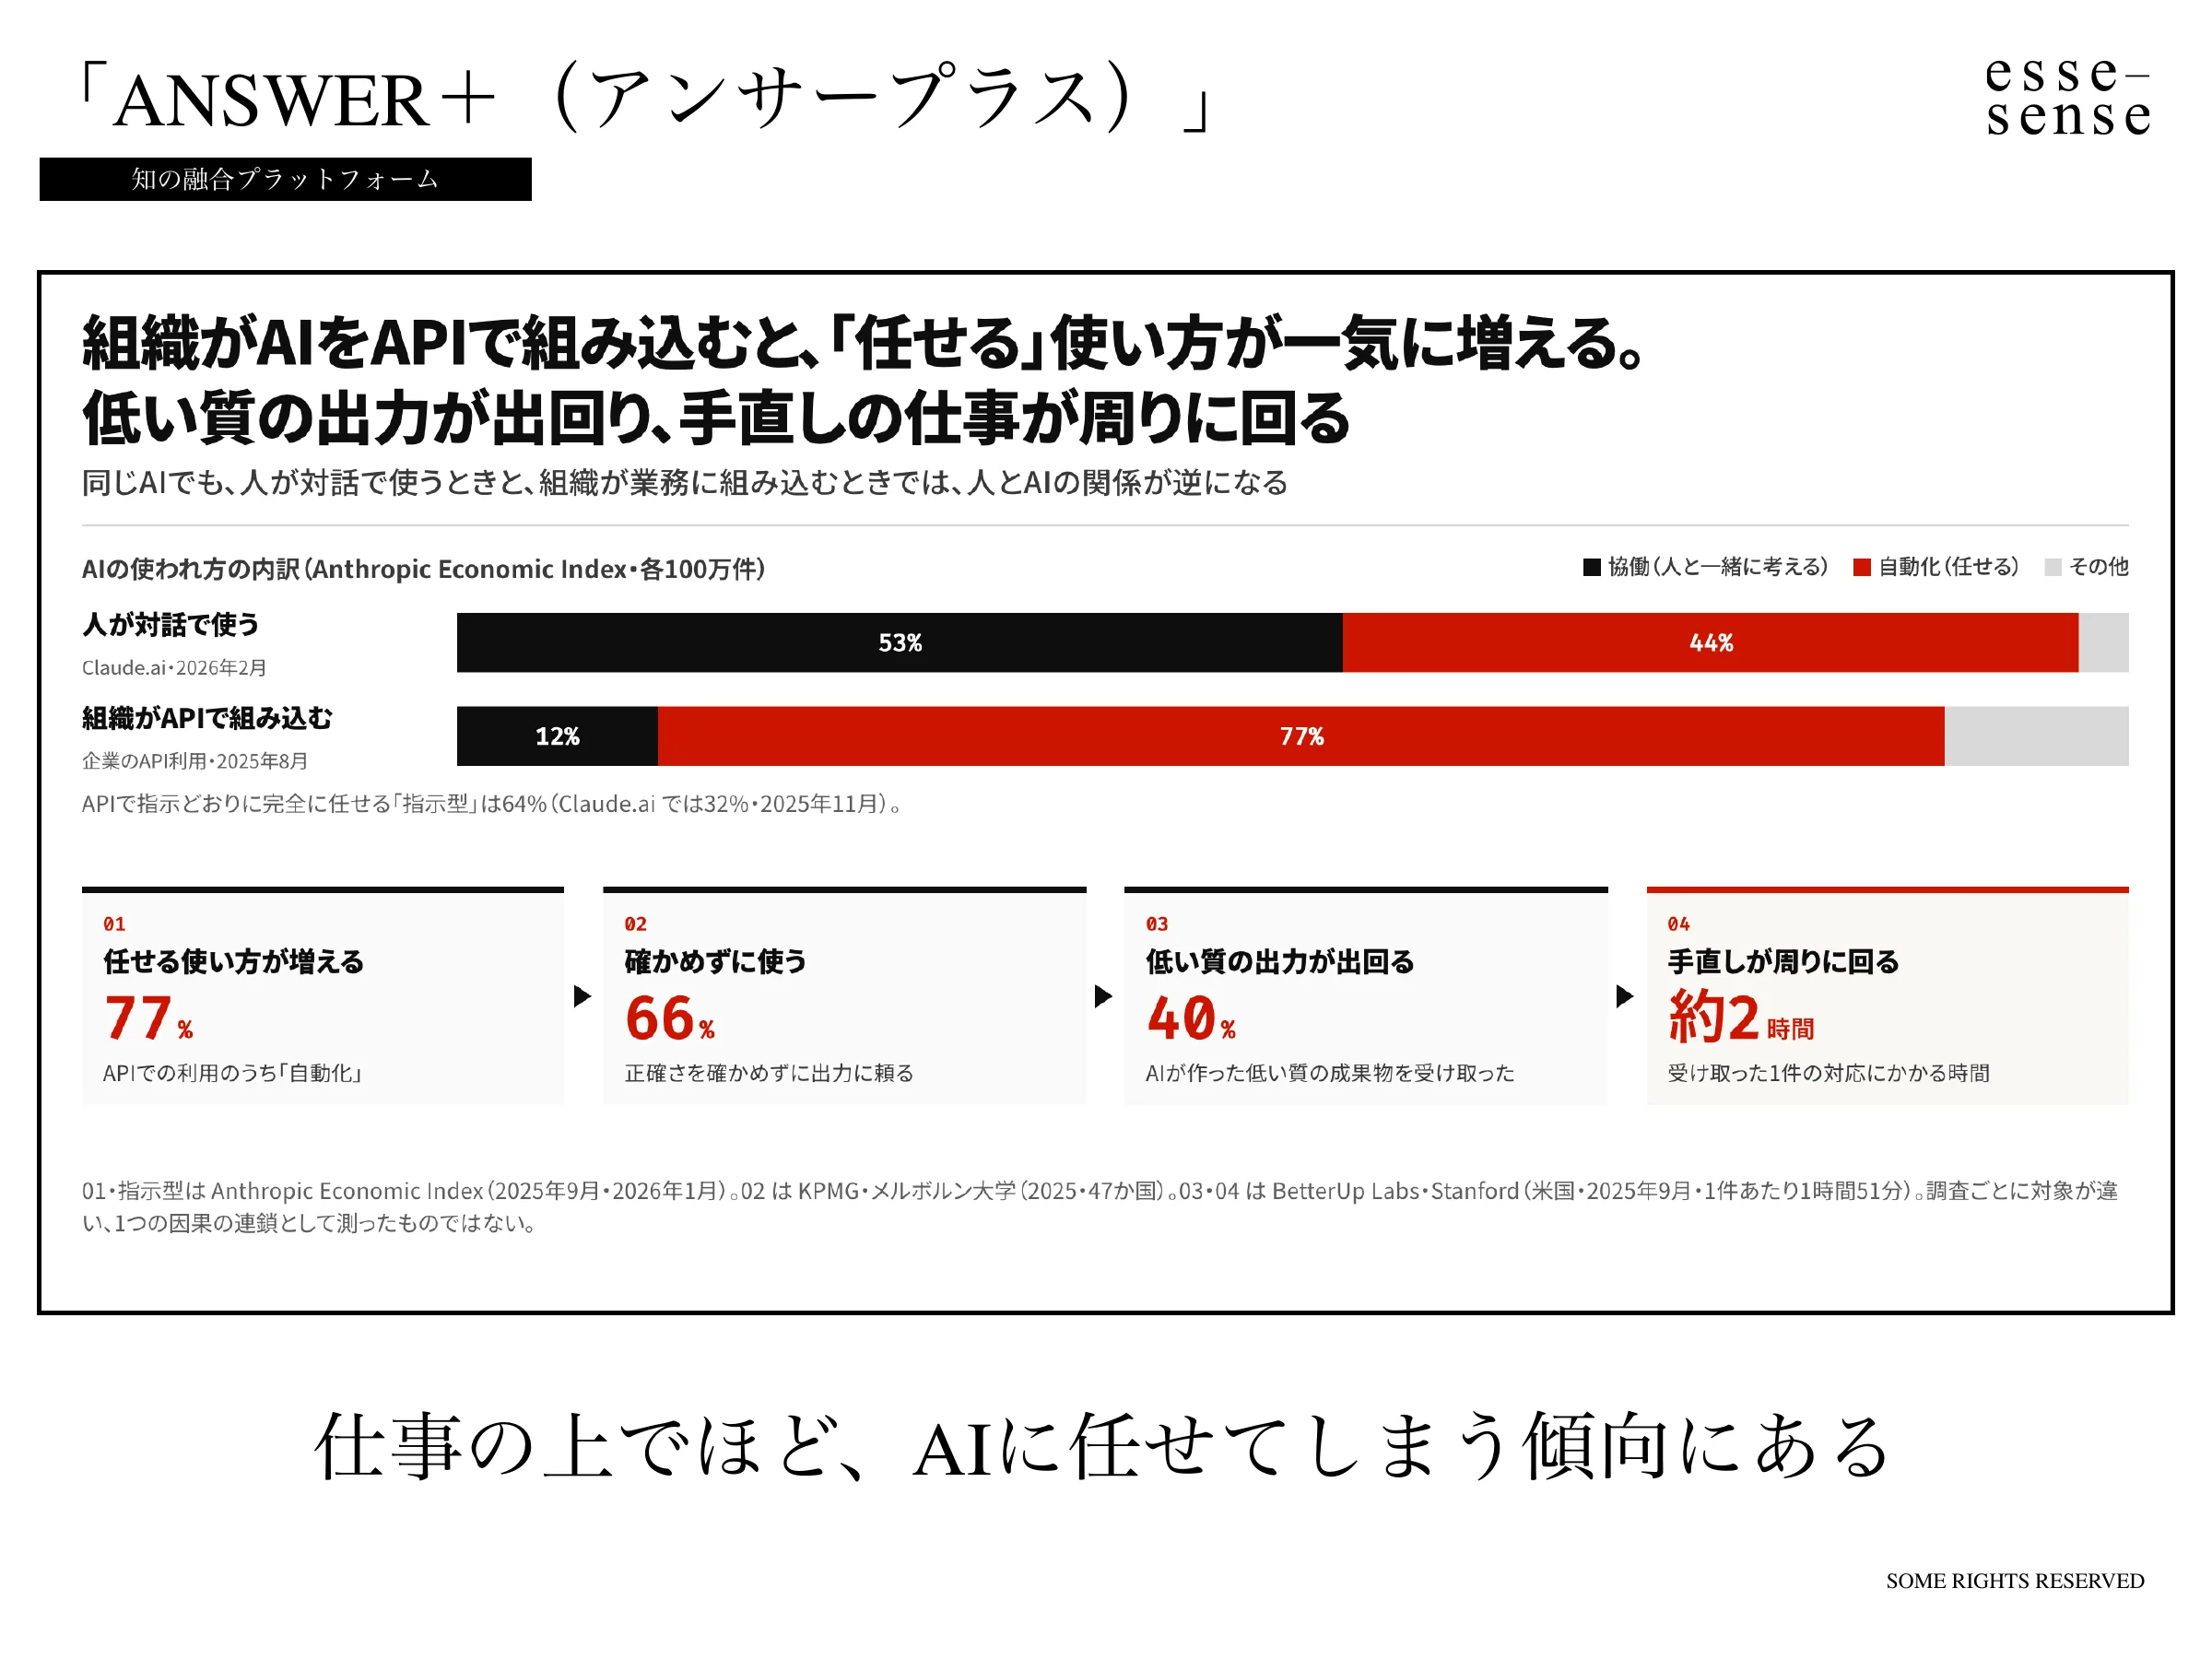
- 確かめる負荷は末端にかかる産業革命の機織りの自動化では、全自動になったわけではなく、各所に自動化できない部分が残り、そこに負荷が爆増したと西村は述べた。同じ見立てをAIに当てると、AIに書いてもらうほど確かめる・直す・元の資料に当たるという末端の負荷が増え、それを隠して渡せば相手に負荷が移ると説明した。これを「AIの取りこぼしを拾う新たな労働」と呼び、家庭で使うときより仕事の場面ほど、AIに任せて確かめない傾向があることも併せて紹介した。
- AIには書かせず、記録を引かせる後から確かめ、直し、資料を探し直すのなら、先に確かめて直し、資料が紐づいたものを作ってしまえばよい、という発想だと西村は述べた。検証済みで参照元が分かる情報群を集め、そこから引いてくることをAIの役割にし、人が考えて判断するための支え役に主従を逆転させる。これにより、ハルシネーションと、取りこぼした労働を人が引き受ける新しい負荷という2つの課題をなくそうとしていると説明した。
- データベースは「十分さ」で組むANSWER+のもとには292のデータベースが4億3000万レコードを持ち、研究者や論文のほか、IR・投資・プレスリリース・政策・未来洞察の情報が入っていると西村は述べた。量の基準は、ある回答に十分な情報量という「理論的飽和」の考え方で、100でなく99でも足りるなら回答できるとし、15年ほど続けてきた方法を自動化したと説明した。1つのデータベースを徹底的に大きくするのではなく、観点ごとに複数が補い合う形にし、半年かけて7600億トークンの計算を行ったと紹介した。
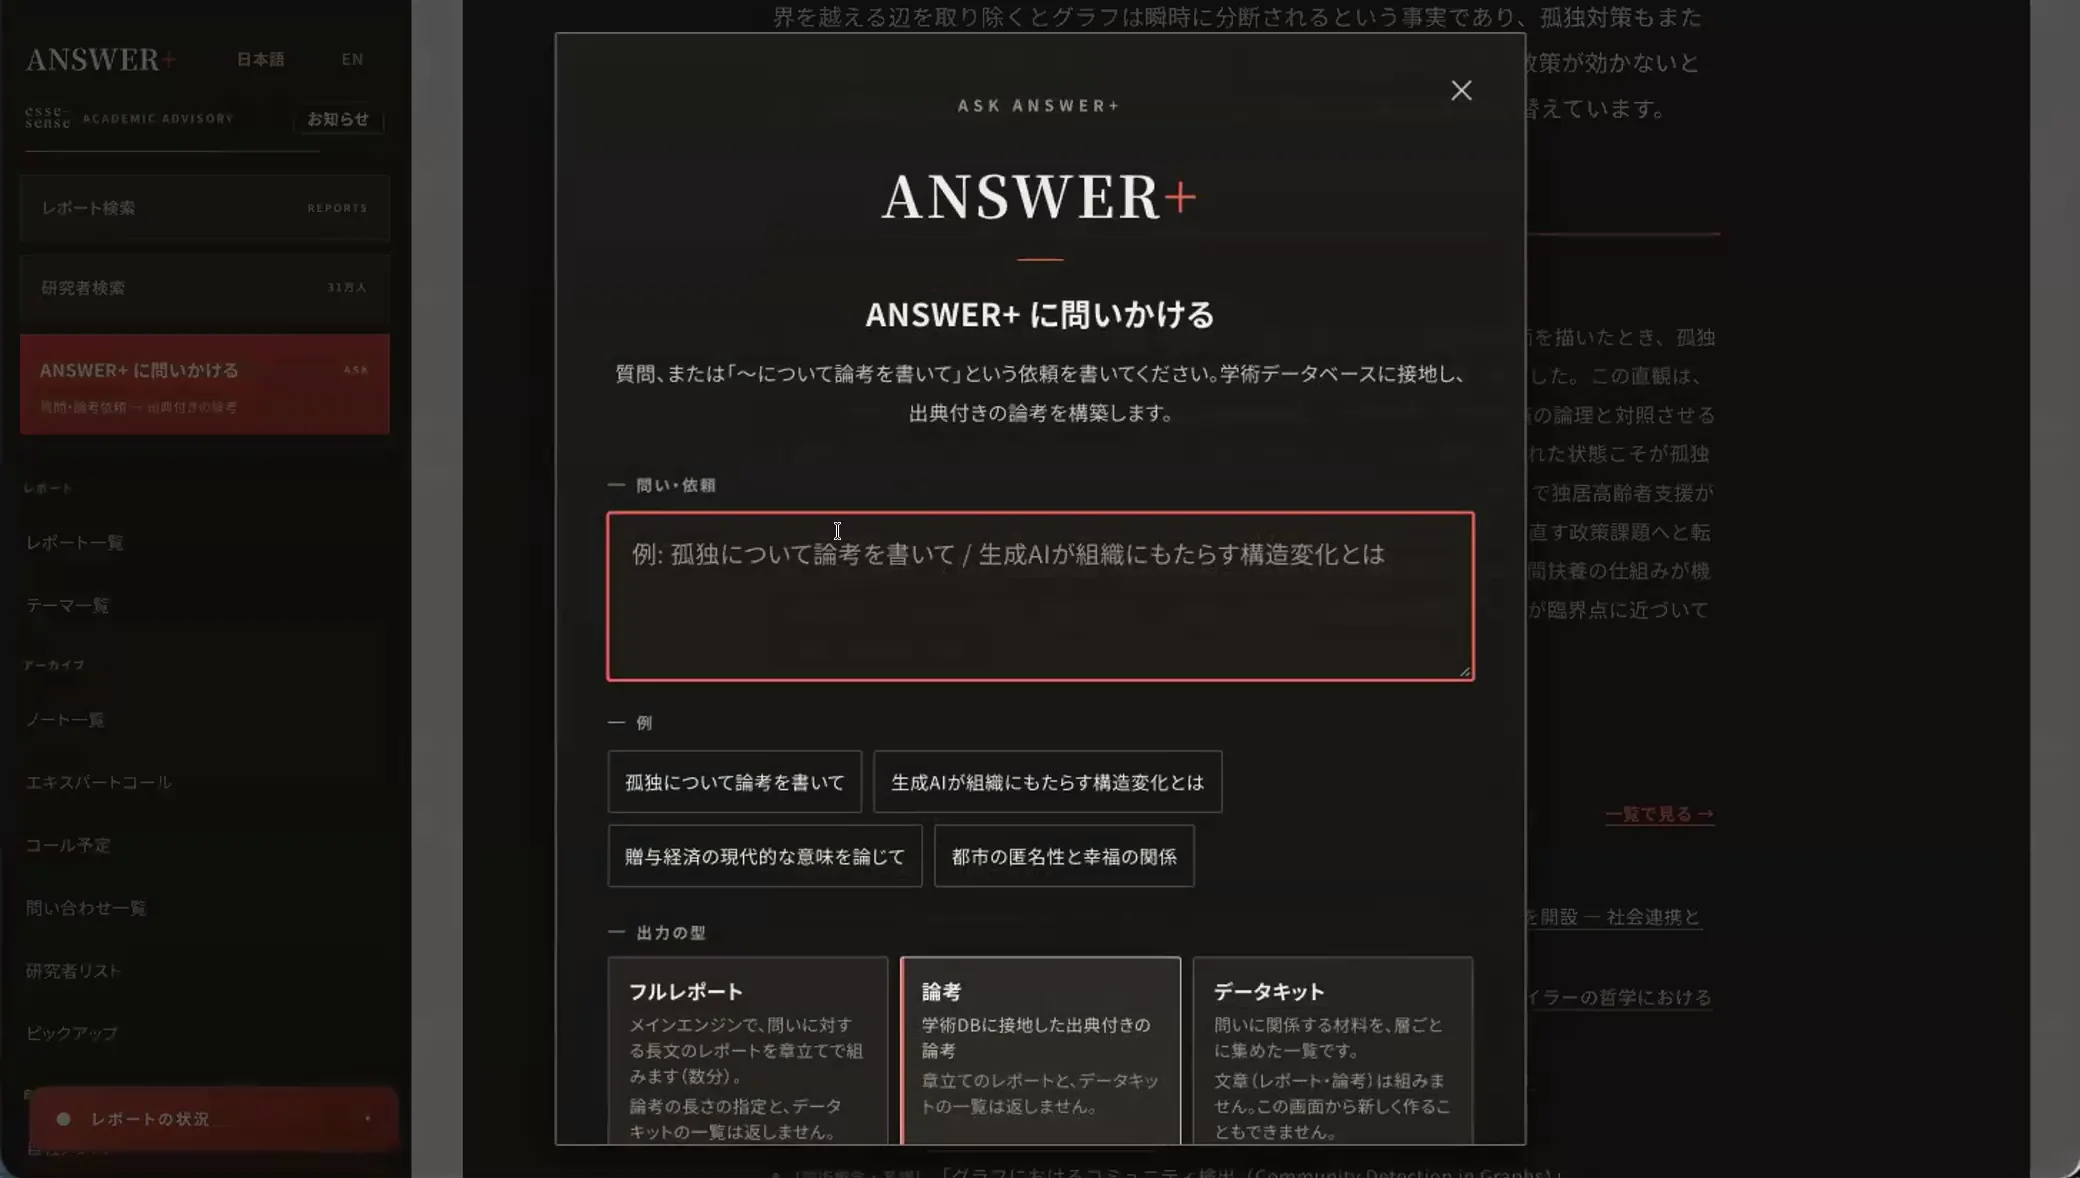
- デモでは、AIは電話交換手の役だけを担う実演では「孤独」についての論考を依頼し、フルレポート・短めのレポート・データキットから出力の形を選んで聞くだけだと西村は説明した。問いに関連する情報が292のデータベースのどこにあるかを探す紐付けの部分をAIが担い、政策・学術・産業など分野の違う素材をまず集める。集まった素材を第1部から第4部の構成に組み立て、間をつなぐ文章を最後に入れる。出てくるものは必ず素材をもとにしているので、誤りの確認コストが減ると述べた。
- まずはオンボーディング付きのトライアルから始める説明会時点の案内として、三浦は1ヶ月の利用で3名分のトライアルが50万円、ベーシックが月々80万円、自社の内部データとANSWER+のデータを結合して出力するエンタープライズがあると案内した。トライアルでは、ただ使うのではなく、オンボーディングセッションで利用目的と検証するプロジェクトを設定し、活用の仕方を伝えてから始め、リフレクションを経て正式契約に移行すると説明した。関心のある人はアンケートに回答すれば詳細を案内するとし、10月26日の次回開催も告知した。
AIには書かせない。知見で判断する社会へ
説明会で西村は、仕組みの説明に先立って「なぜこのようなことをやっているのか」という問題意識から話を始めた。生成AIの課題、そこから生まれる新しい労働、それに対するANSWER+の仕組みと解決の方向、そして292のデータベースから引く仕組みの順に、発言に沿ってまとめた。
01 生成AIの課題
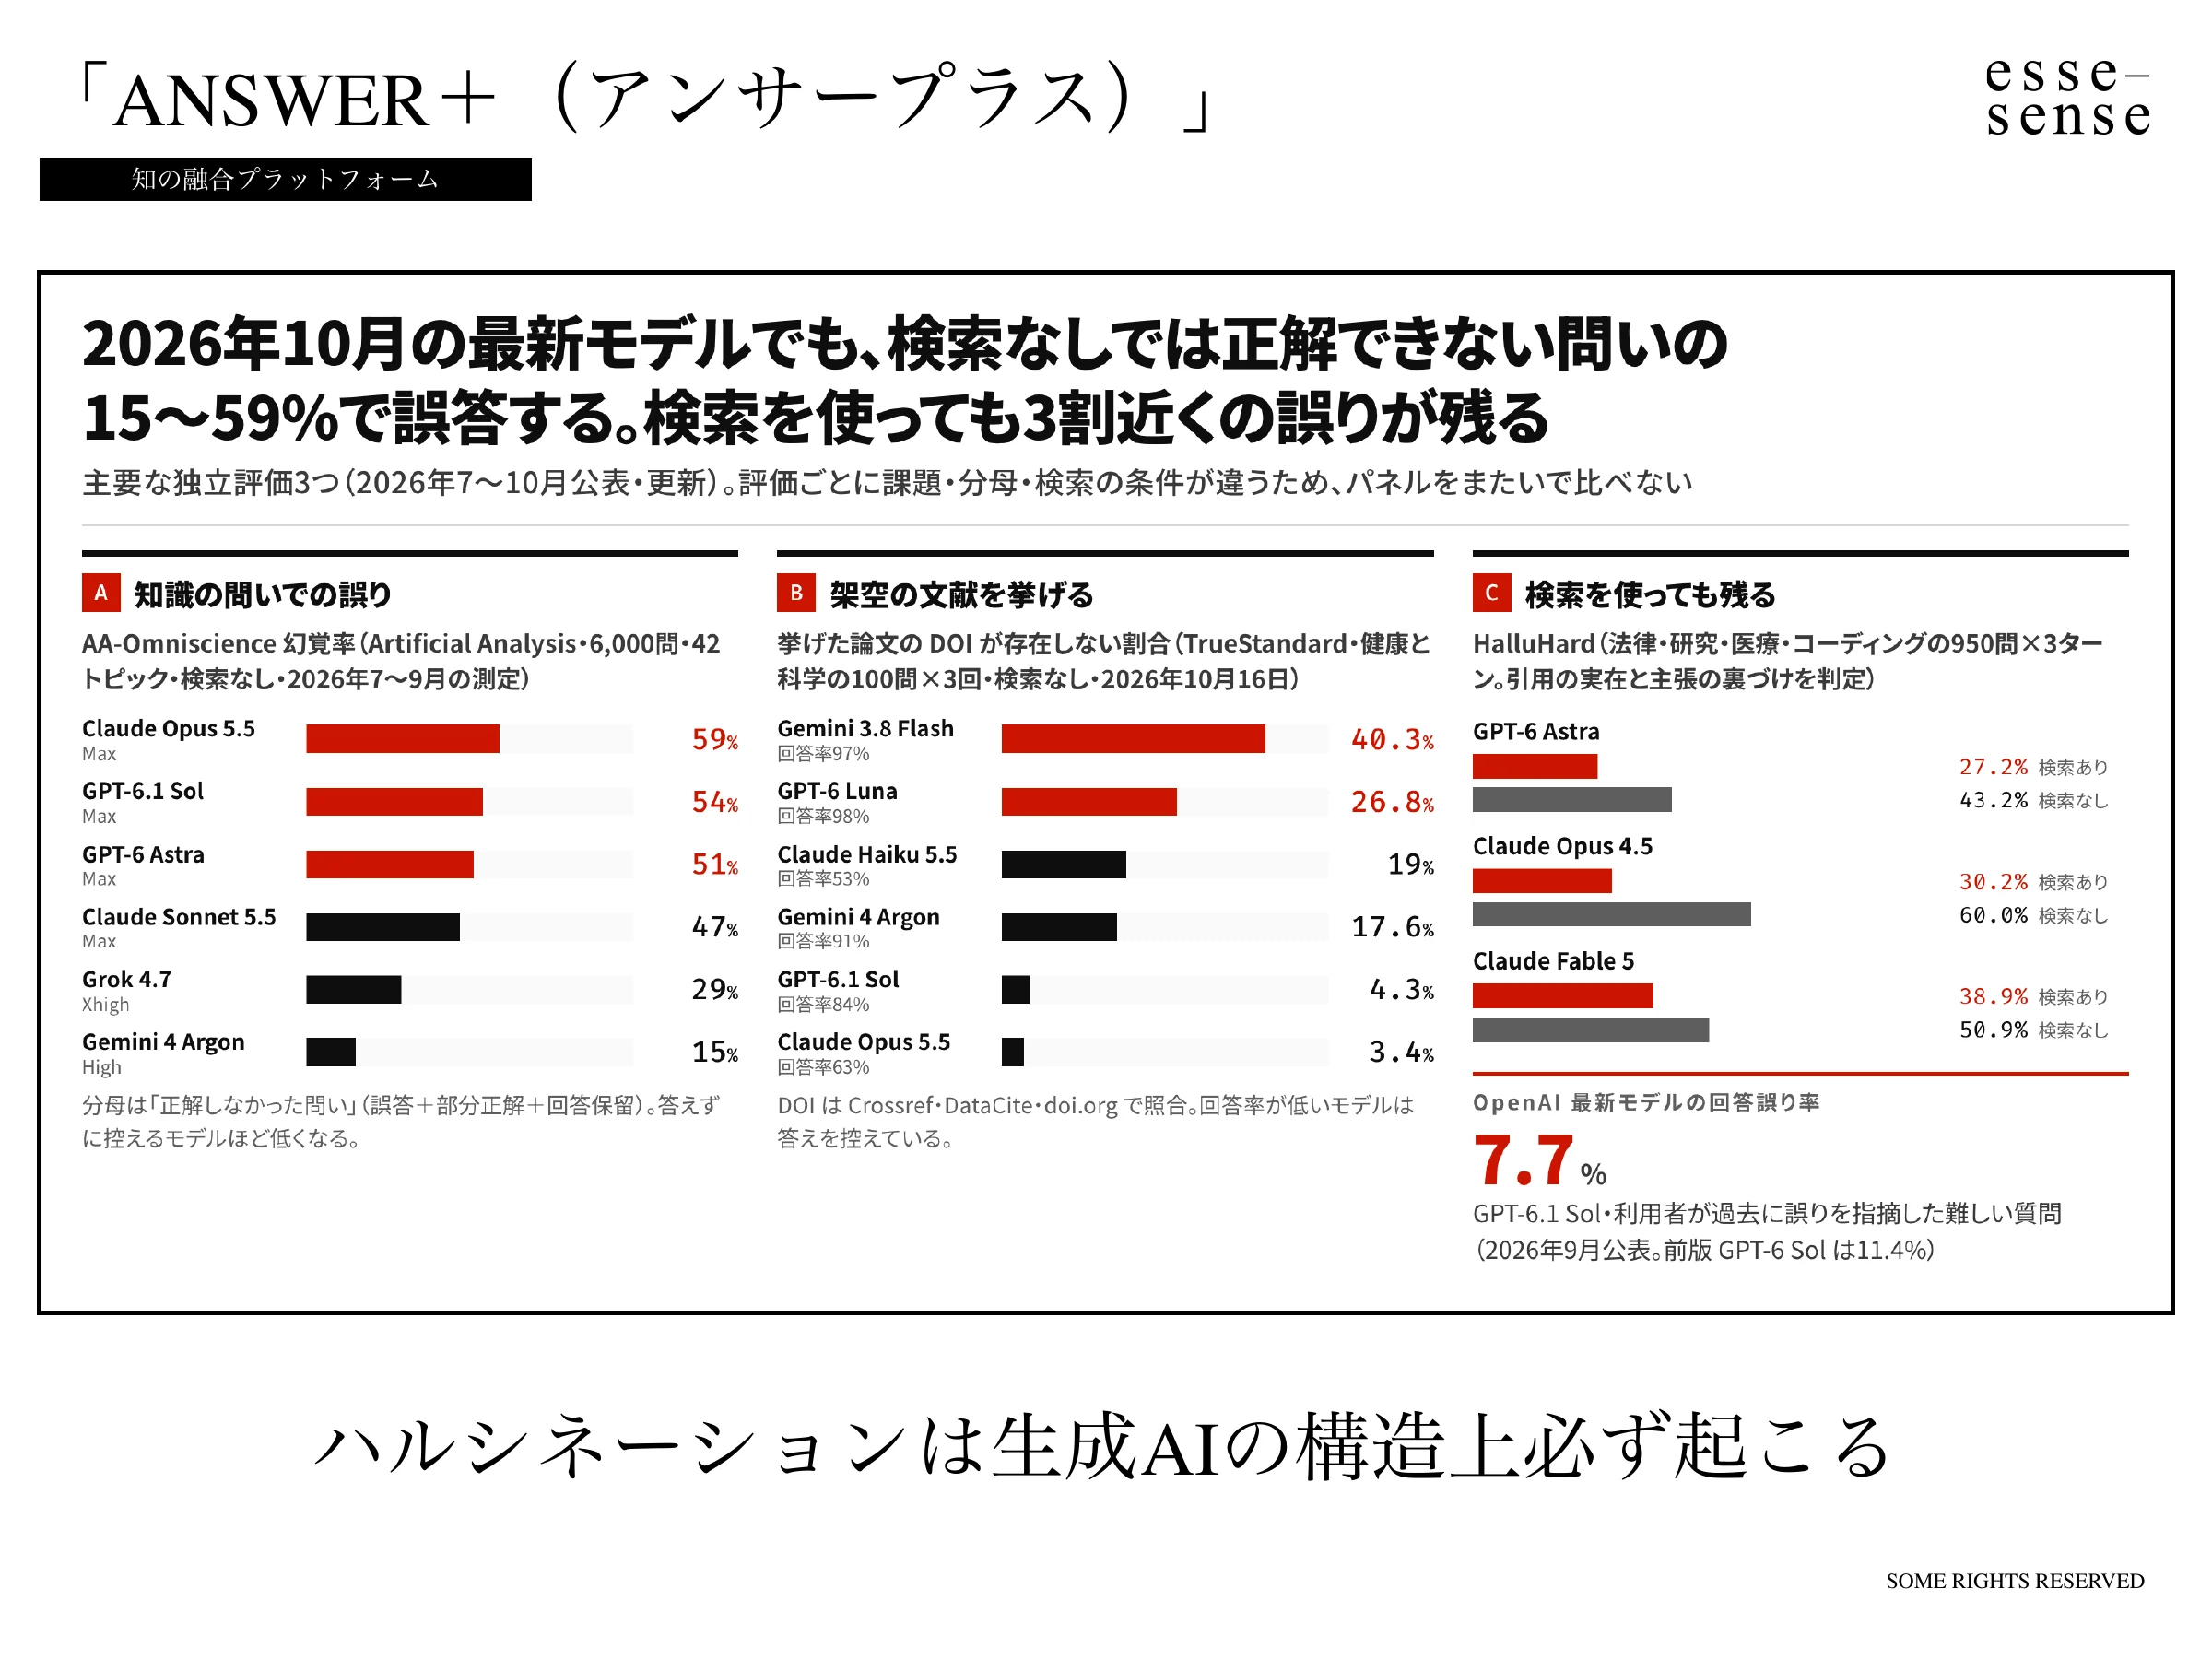
生成AIは、答えるための仕組みとして作られていない
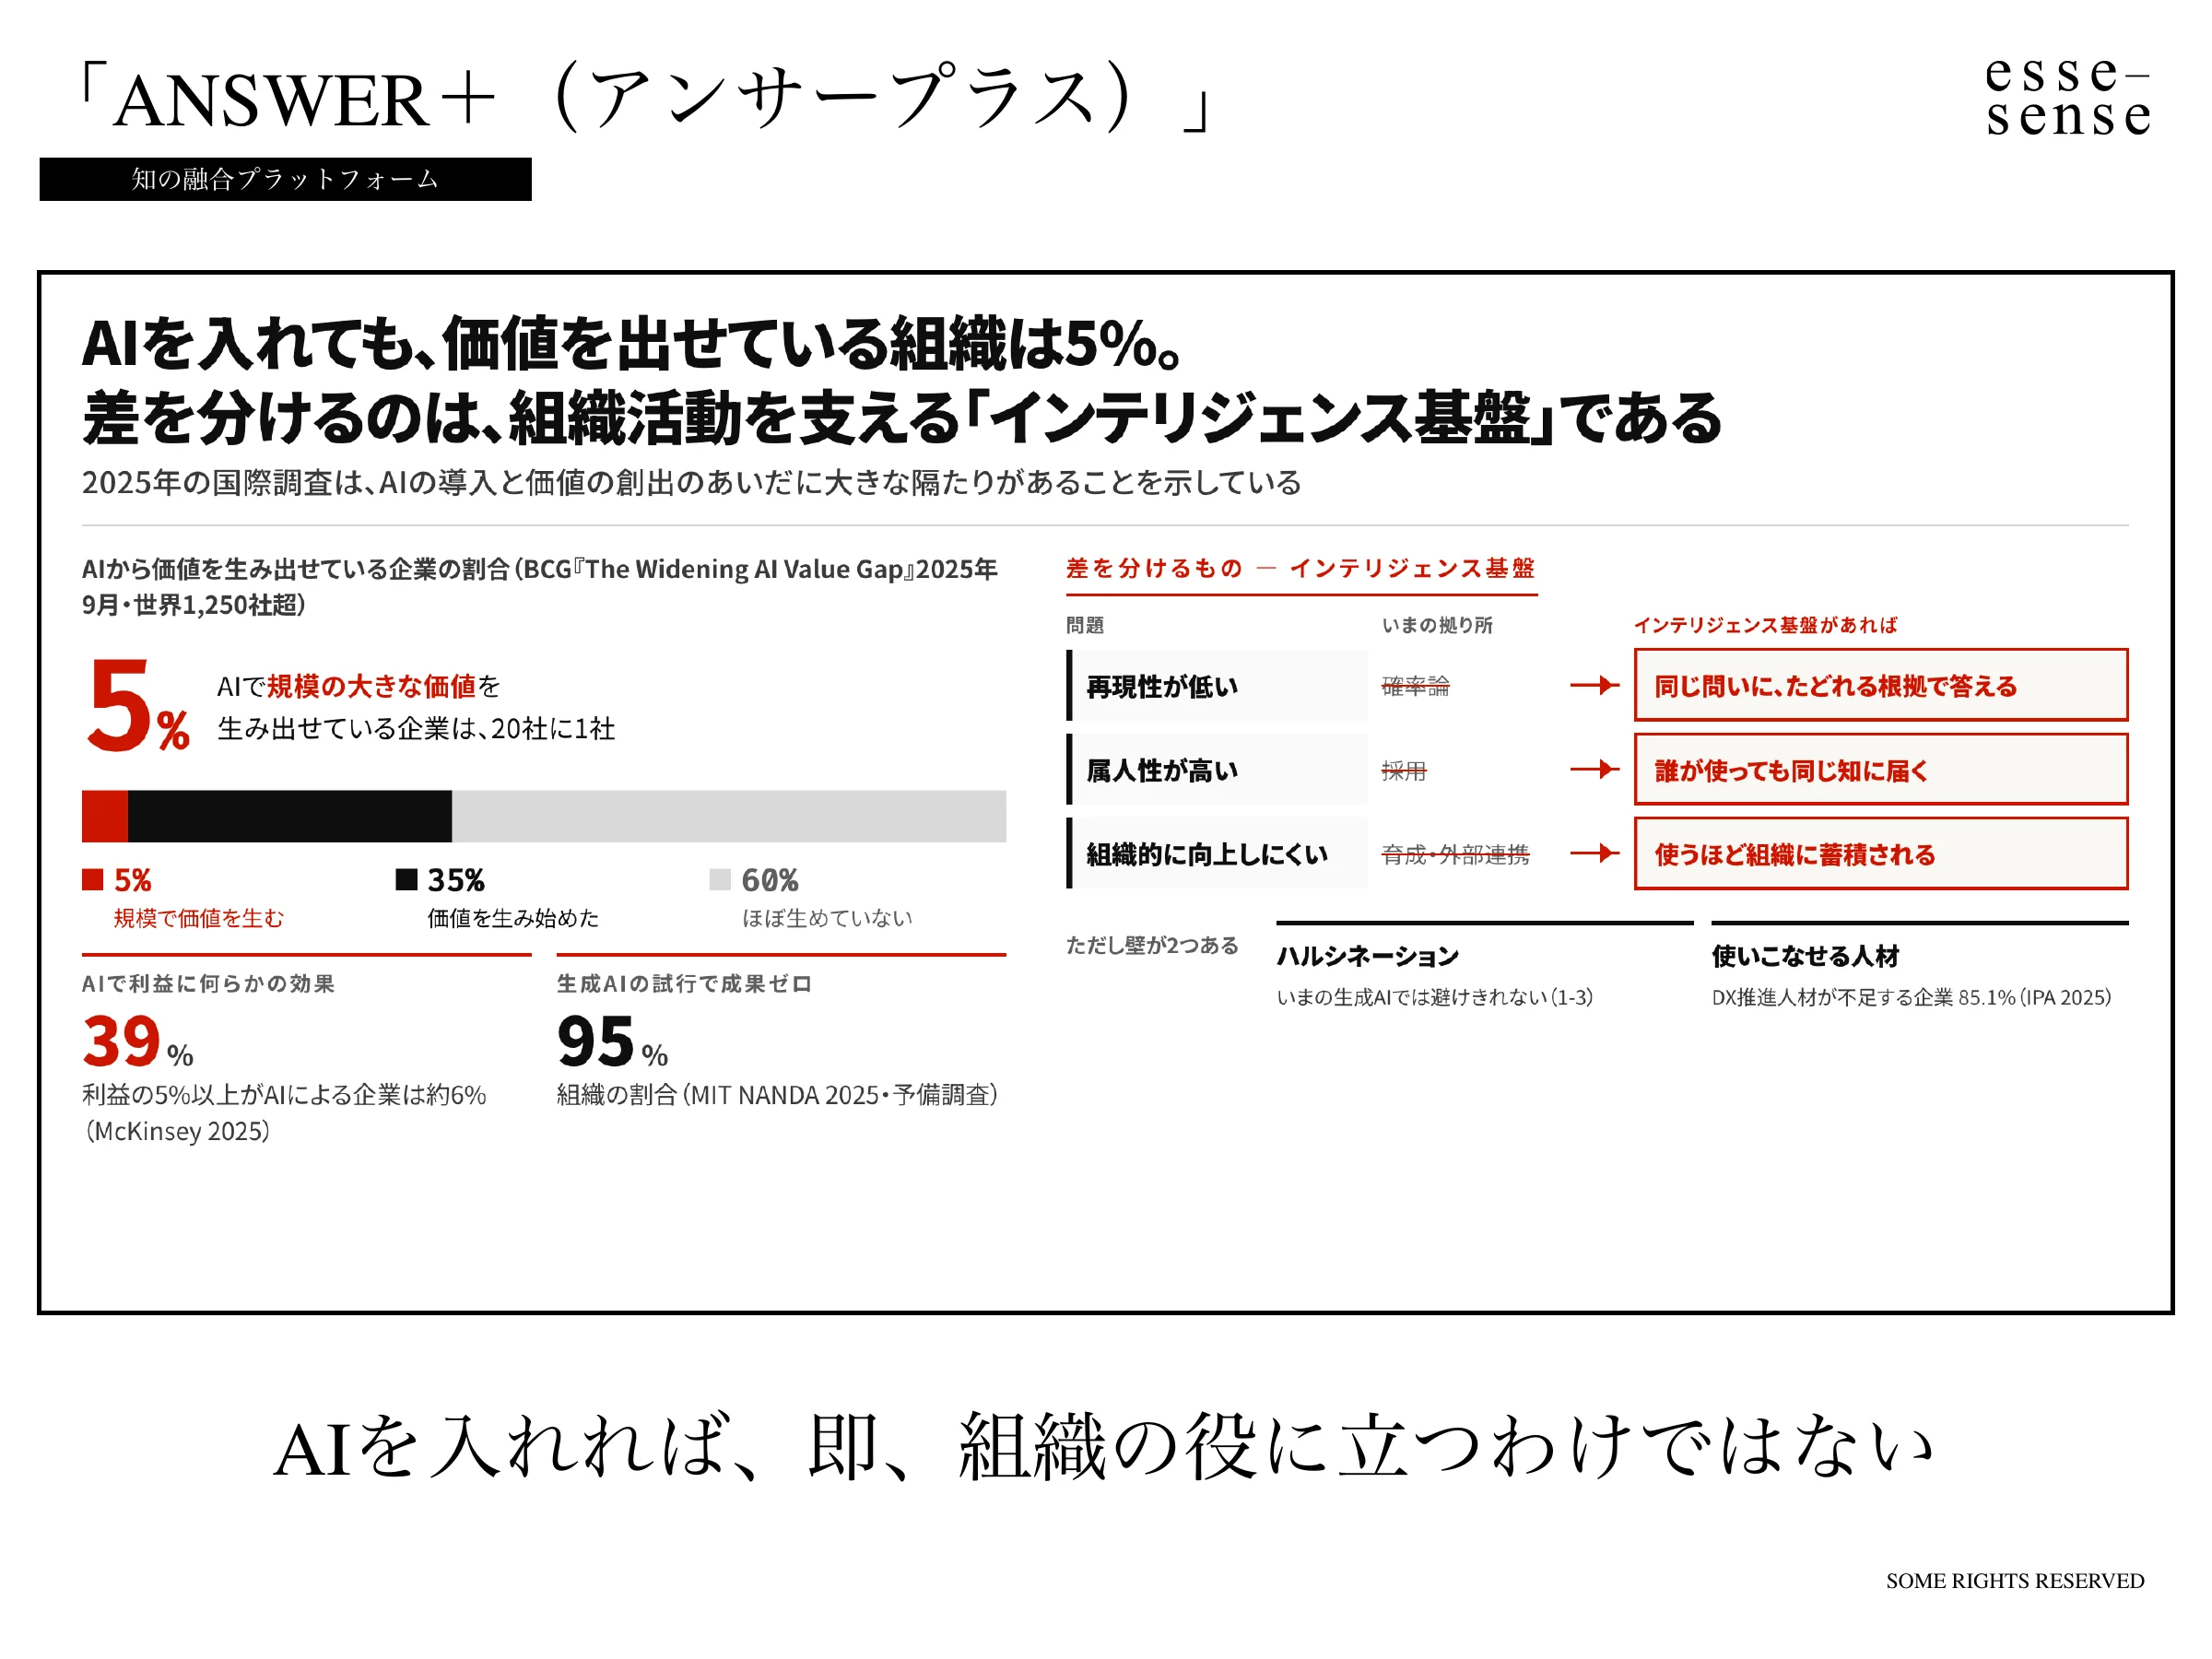
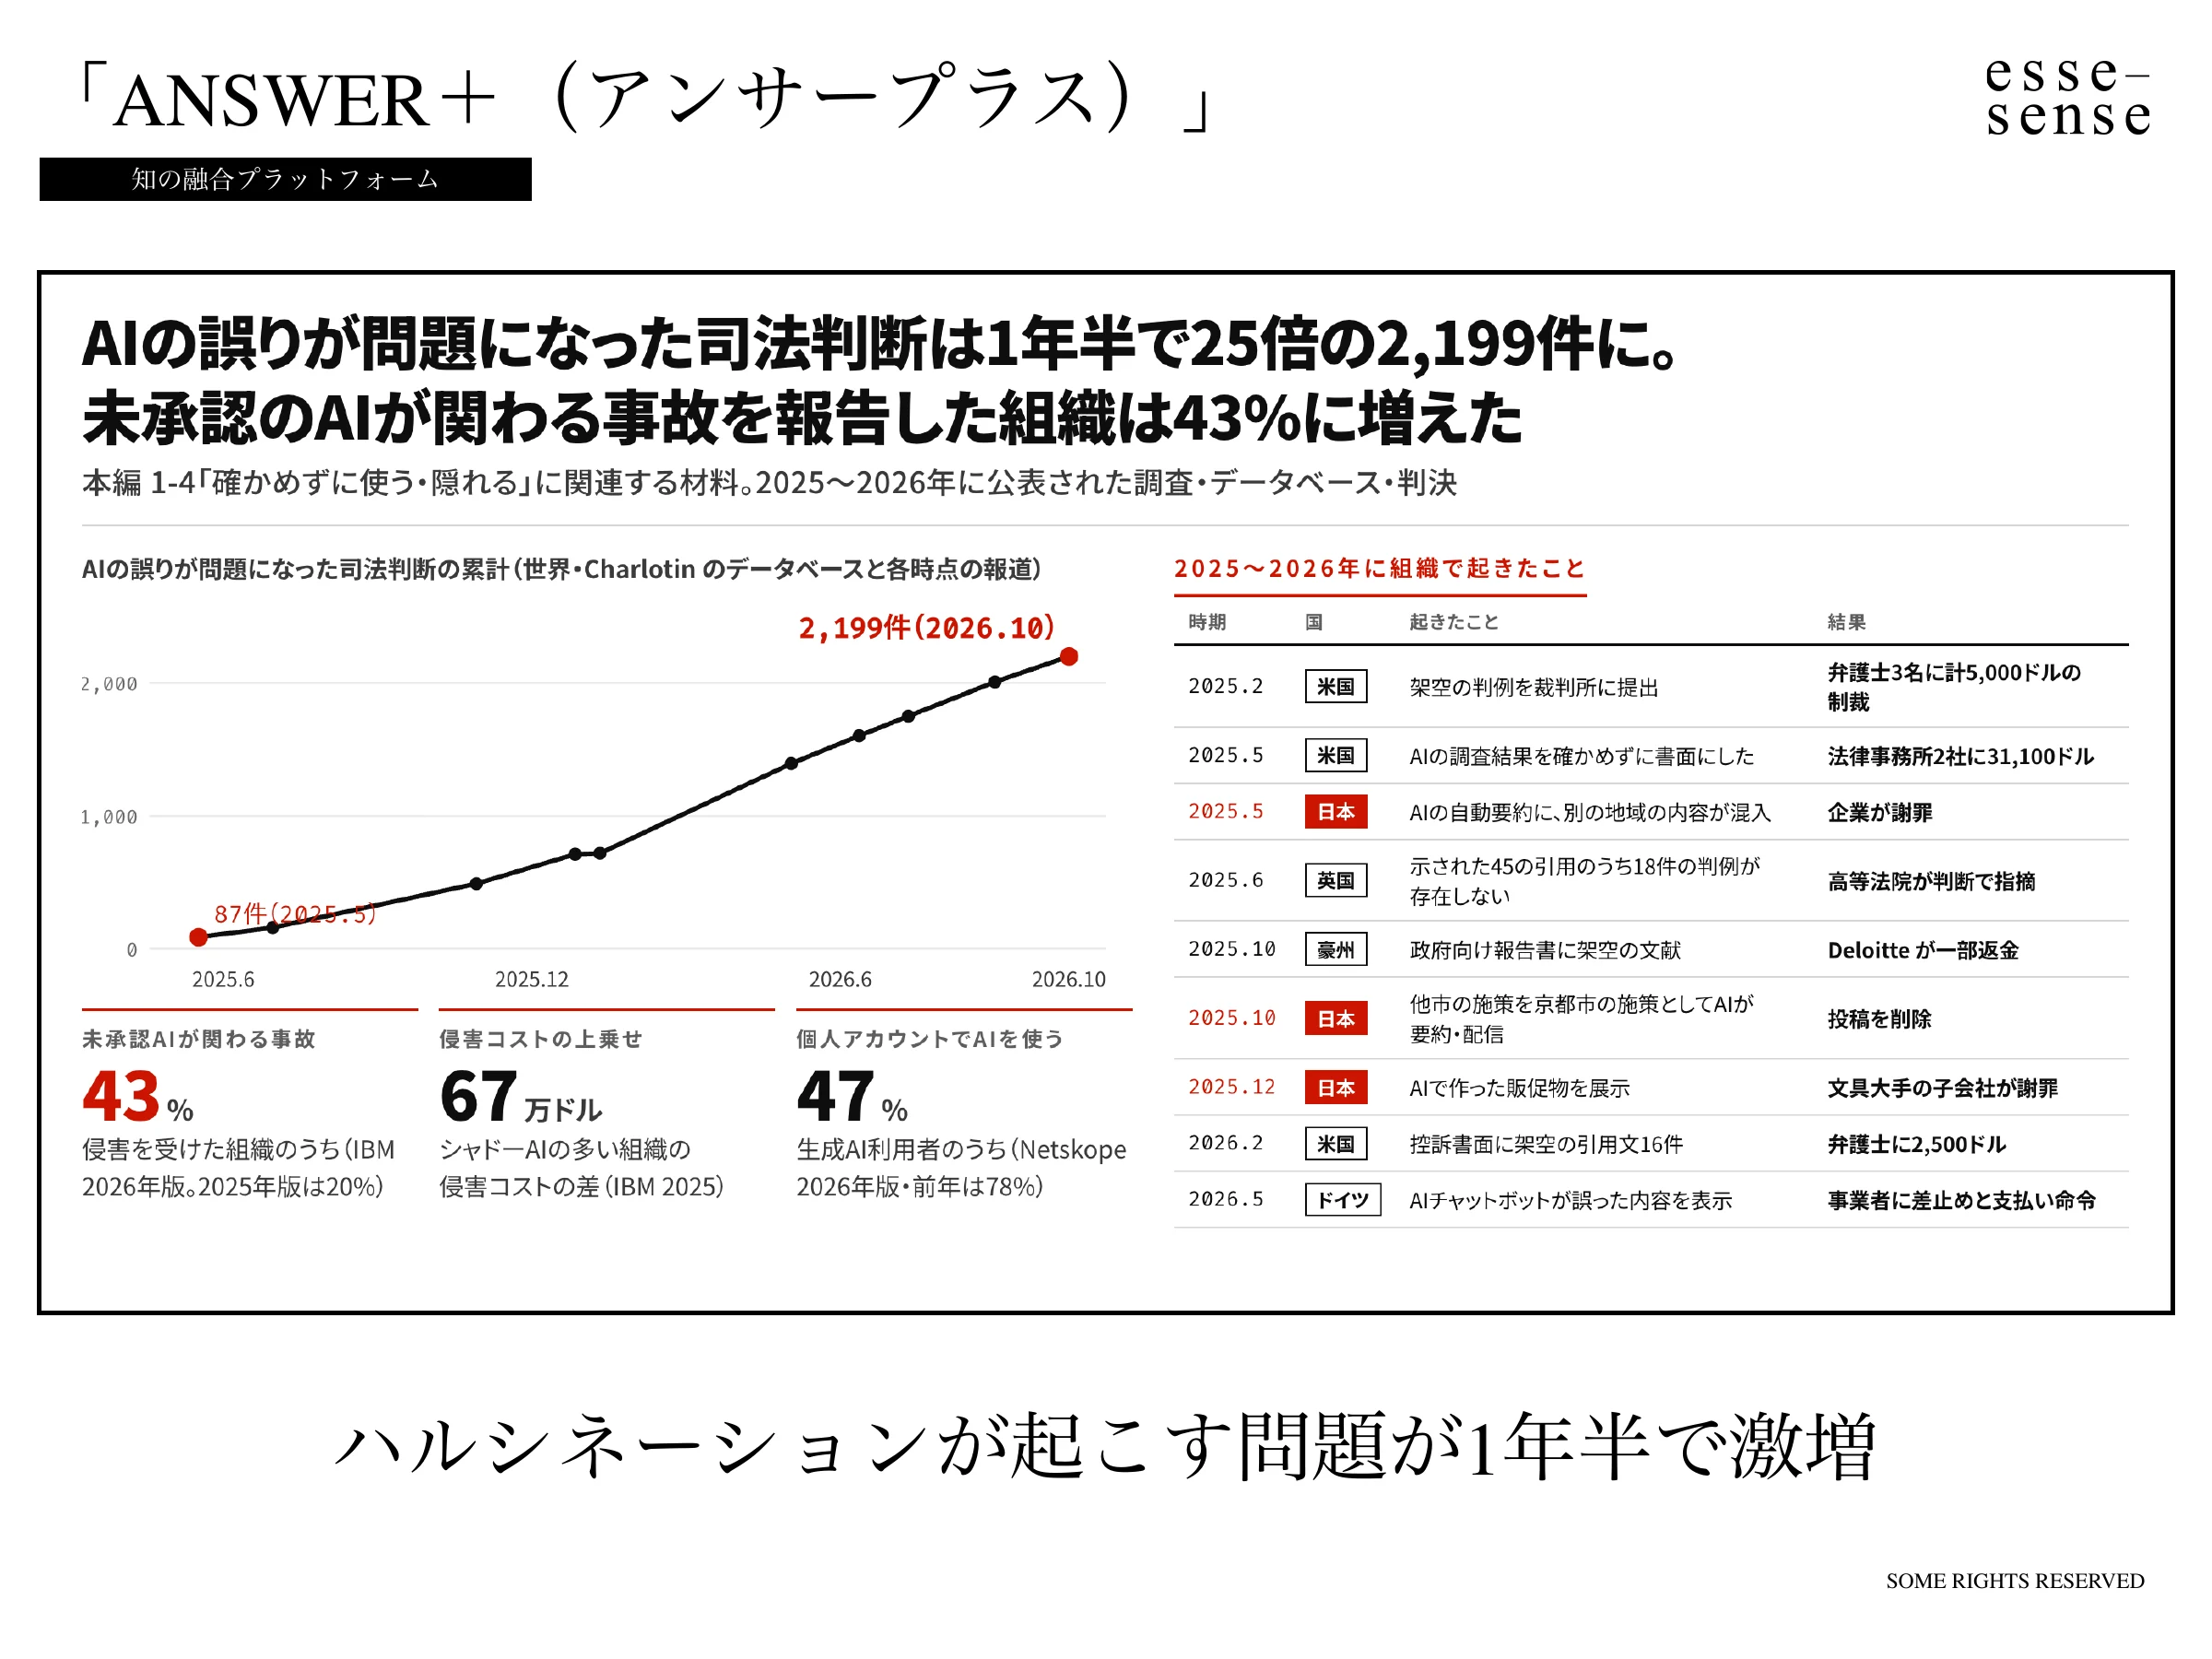
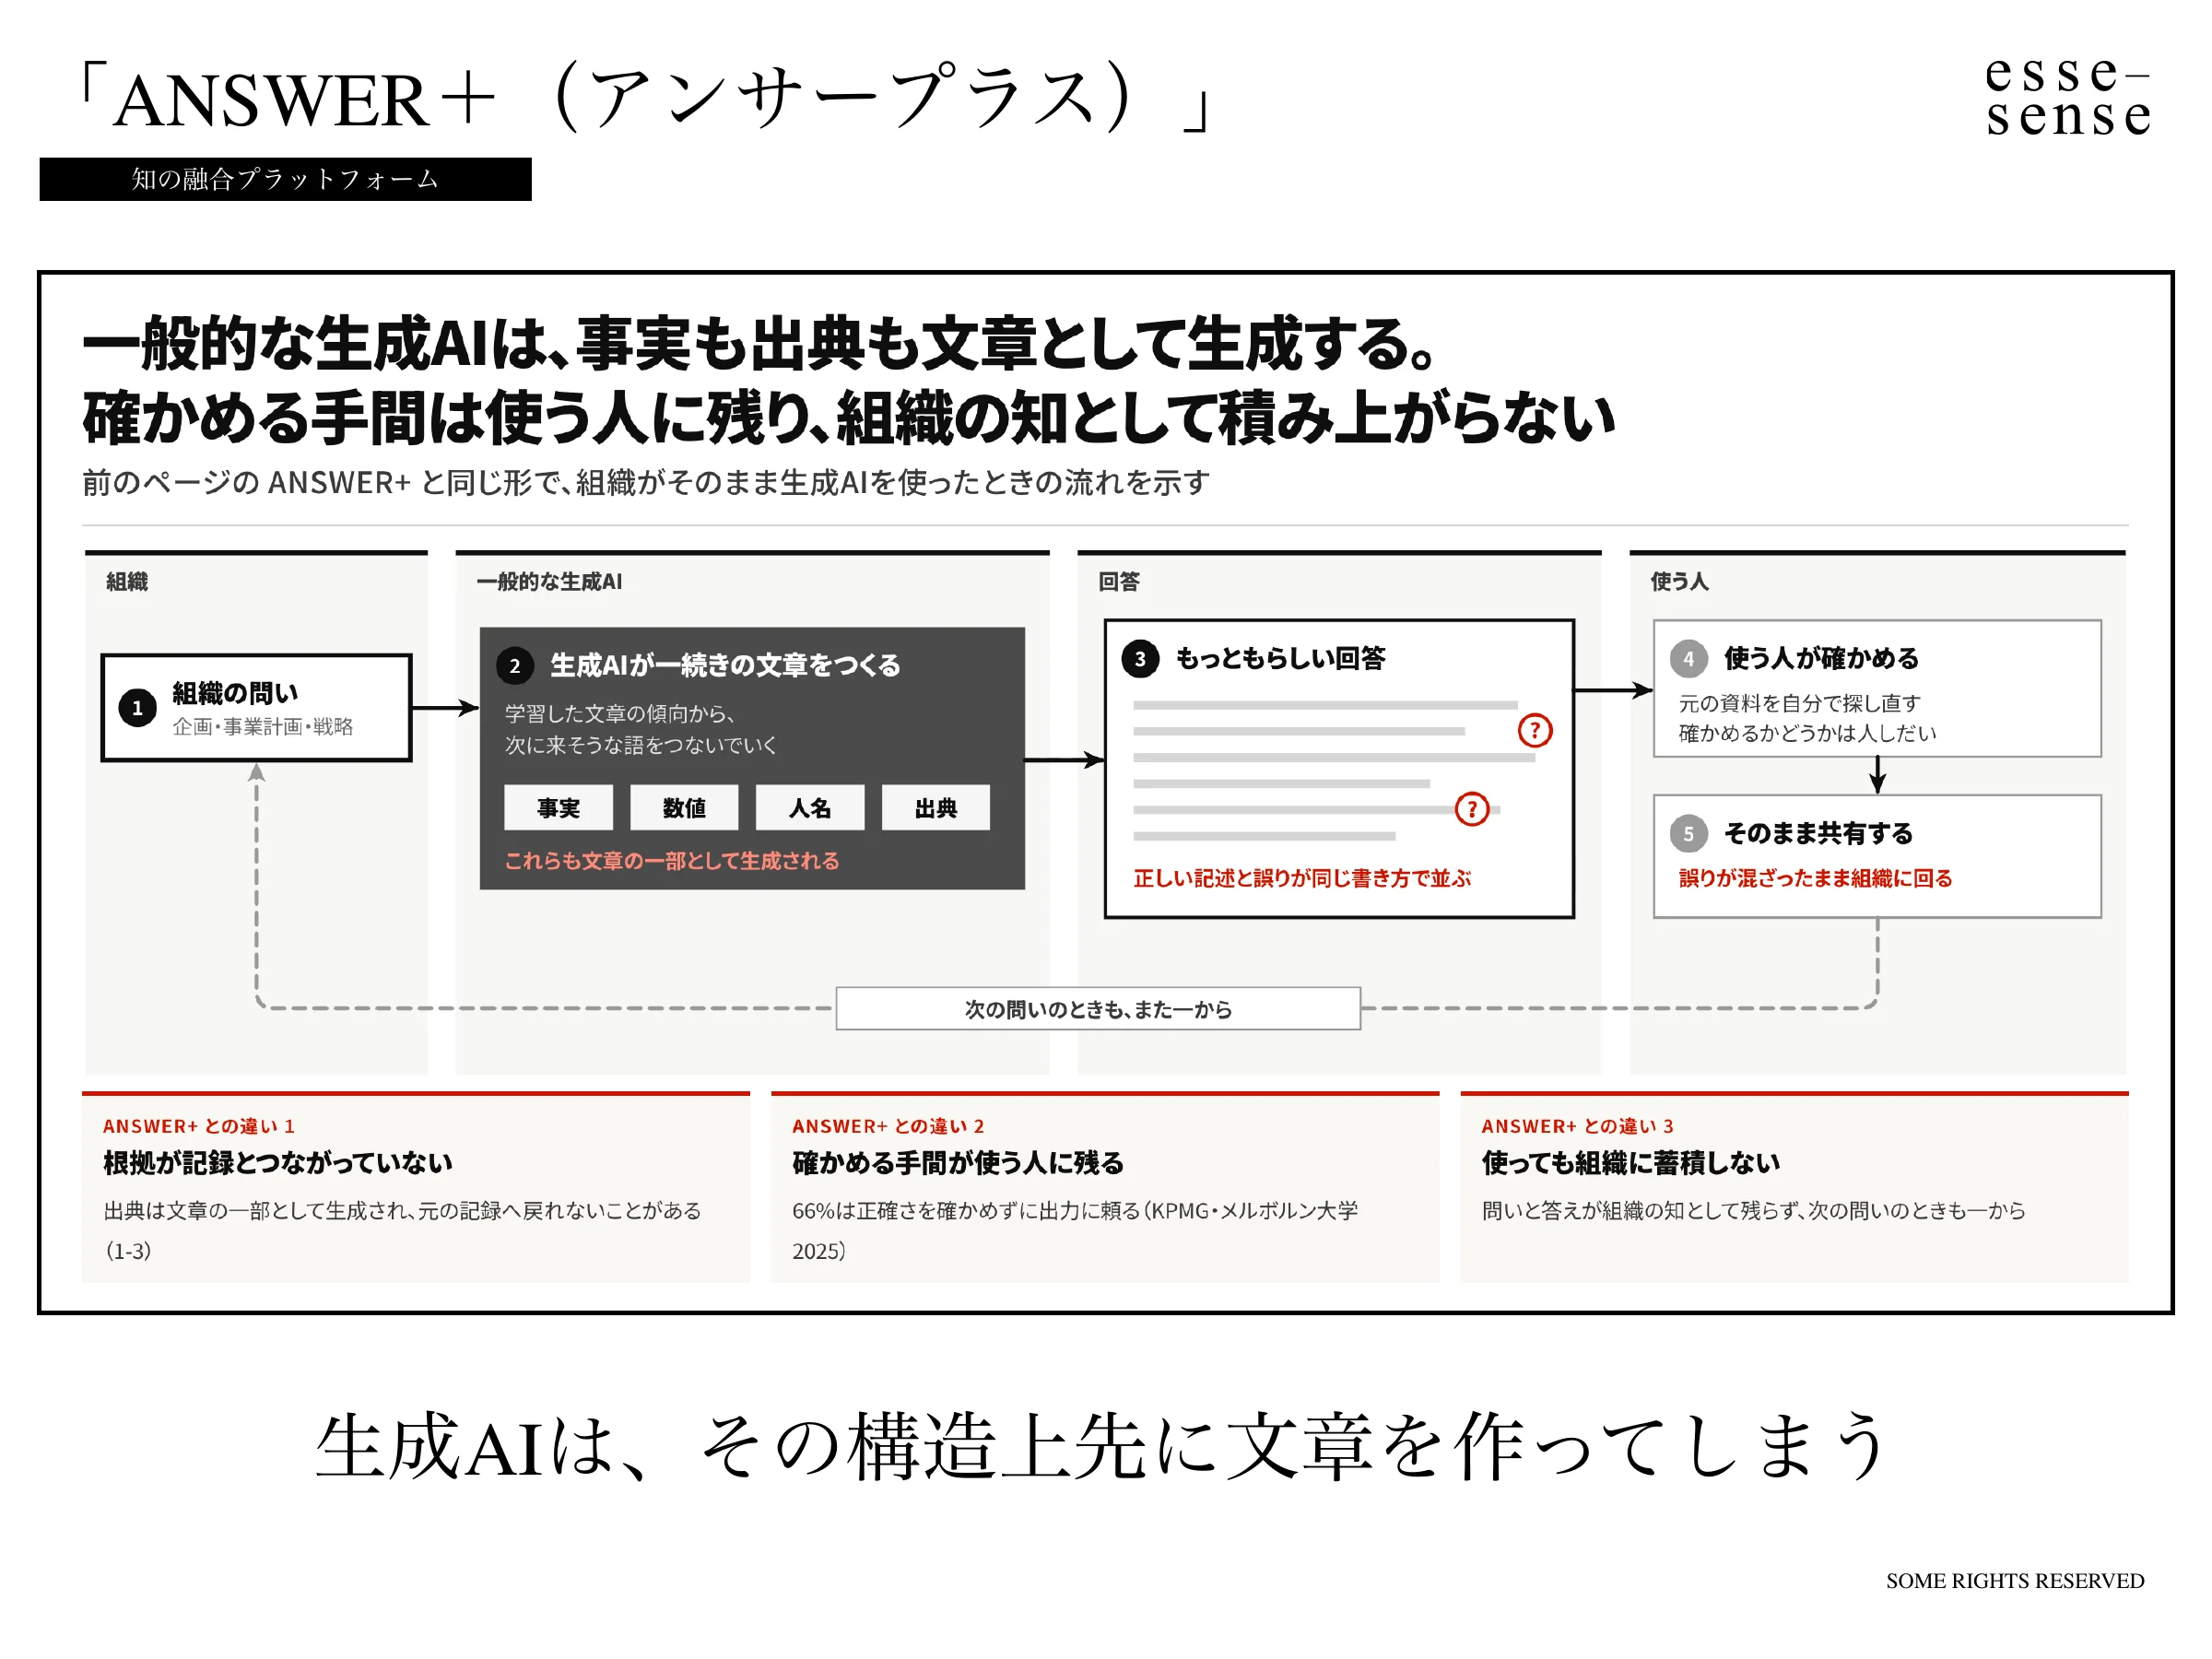
西村は、AIを企業に入れても、それだけでは成果につながらないことが見えてきたと述べ、ある調査では成果を出せているのは100社のうち5社ほどだったと紹介した(調査名は講演で示されていない)。多くの人が結果を確かめずに、使ったことを伏せたまま使い、手直しが受け取った人に回ってくるとも指摘した。西村によれば、2026年のモデルでも、要約に元の文章にないことが混じり、答えが見つからないときには無理に回答を作ってしまう。生成AIはそれらしく言葉を紡ぐ現象であって確実な回答を作る仕組みではないので、ハルシネーションは構造上の問題で、基本的に解消しないと西村は述べた。AIの誤りによる司法的な問題は2025年の87件から2026年10月には2200件近くに増え(集計の出典と数え方は講演で示されていない)、架空の判例の提出や、政府向け報告書への架空の文献の掲載で返金になった例もあると紹介した。
「ハルシネーションというのは構造的な問題なので、解消することは基本的にはない」 ― 映像 13:11 の発言
02 取りこぼしを拾う労働
速く書かせるほど、確かめる仕事が末端に積み上がるのではないか
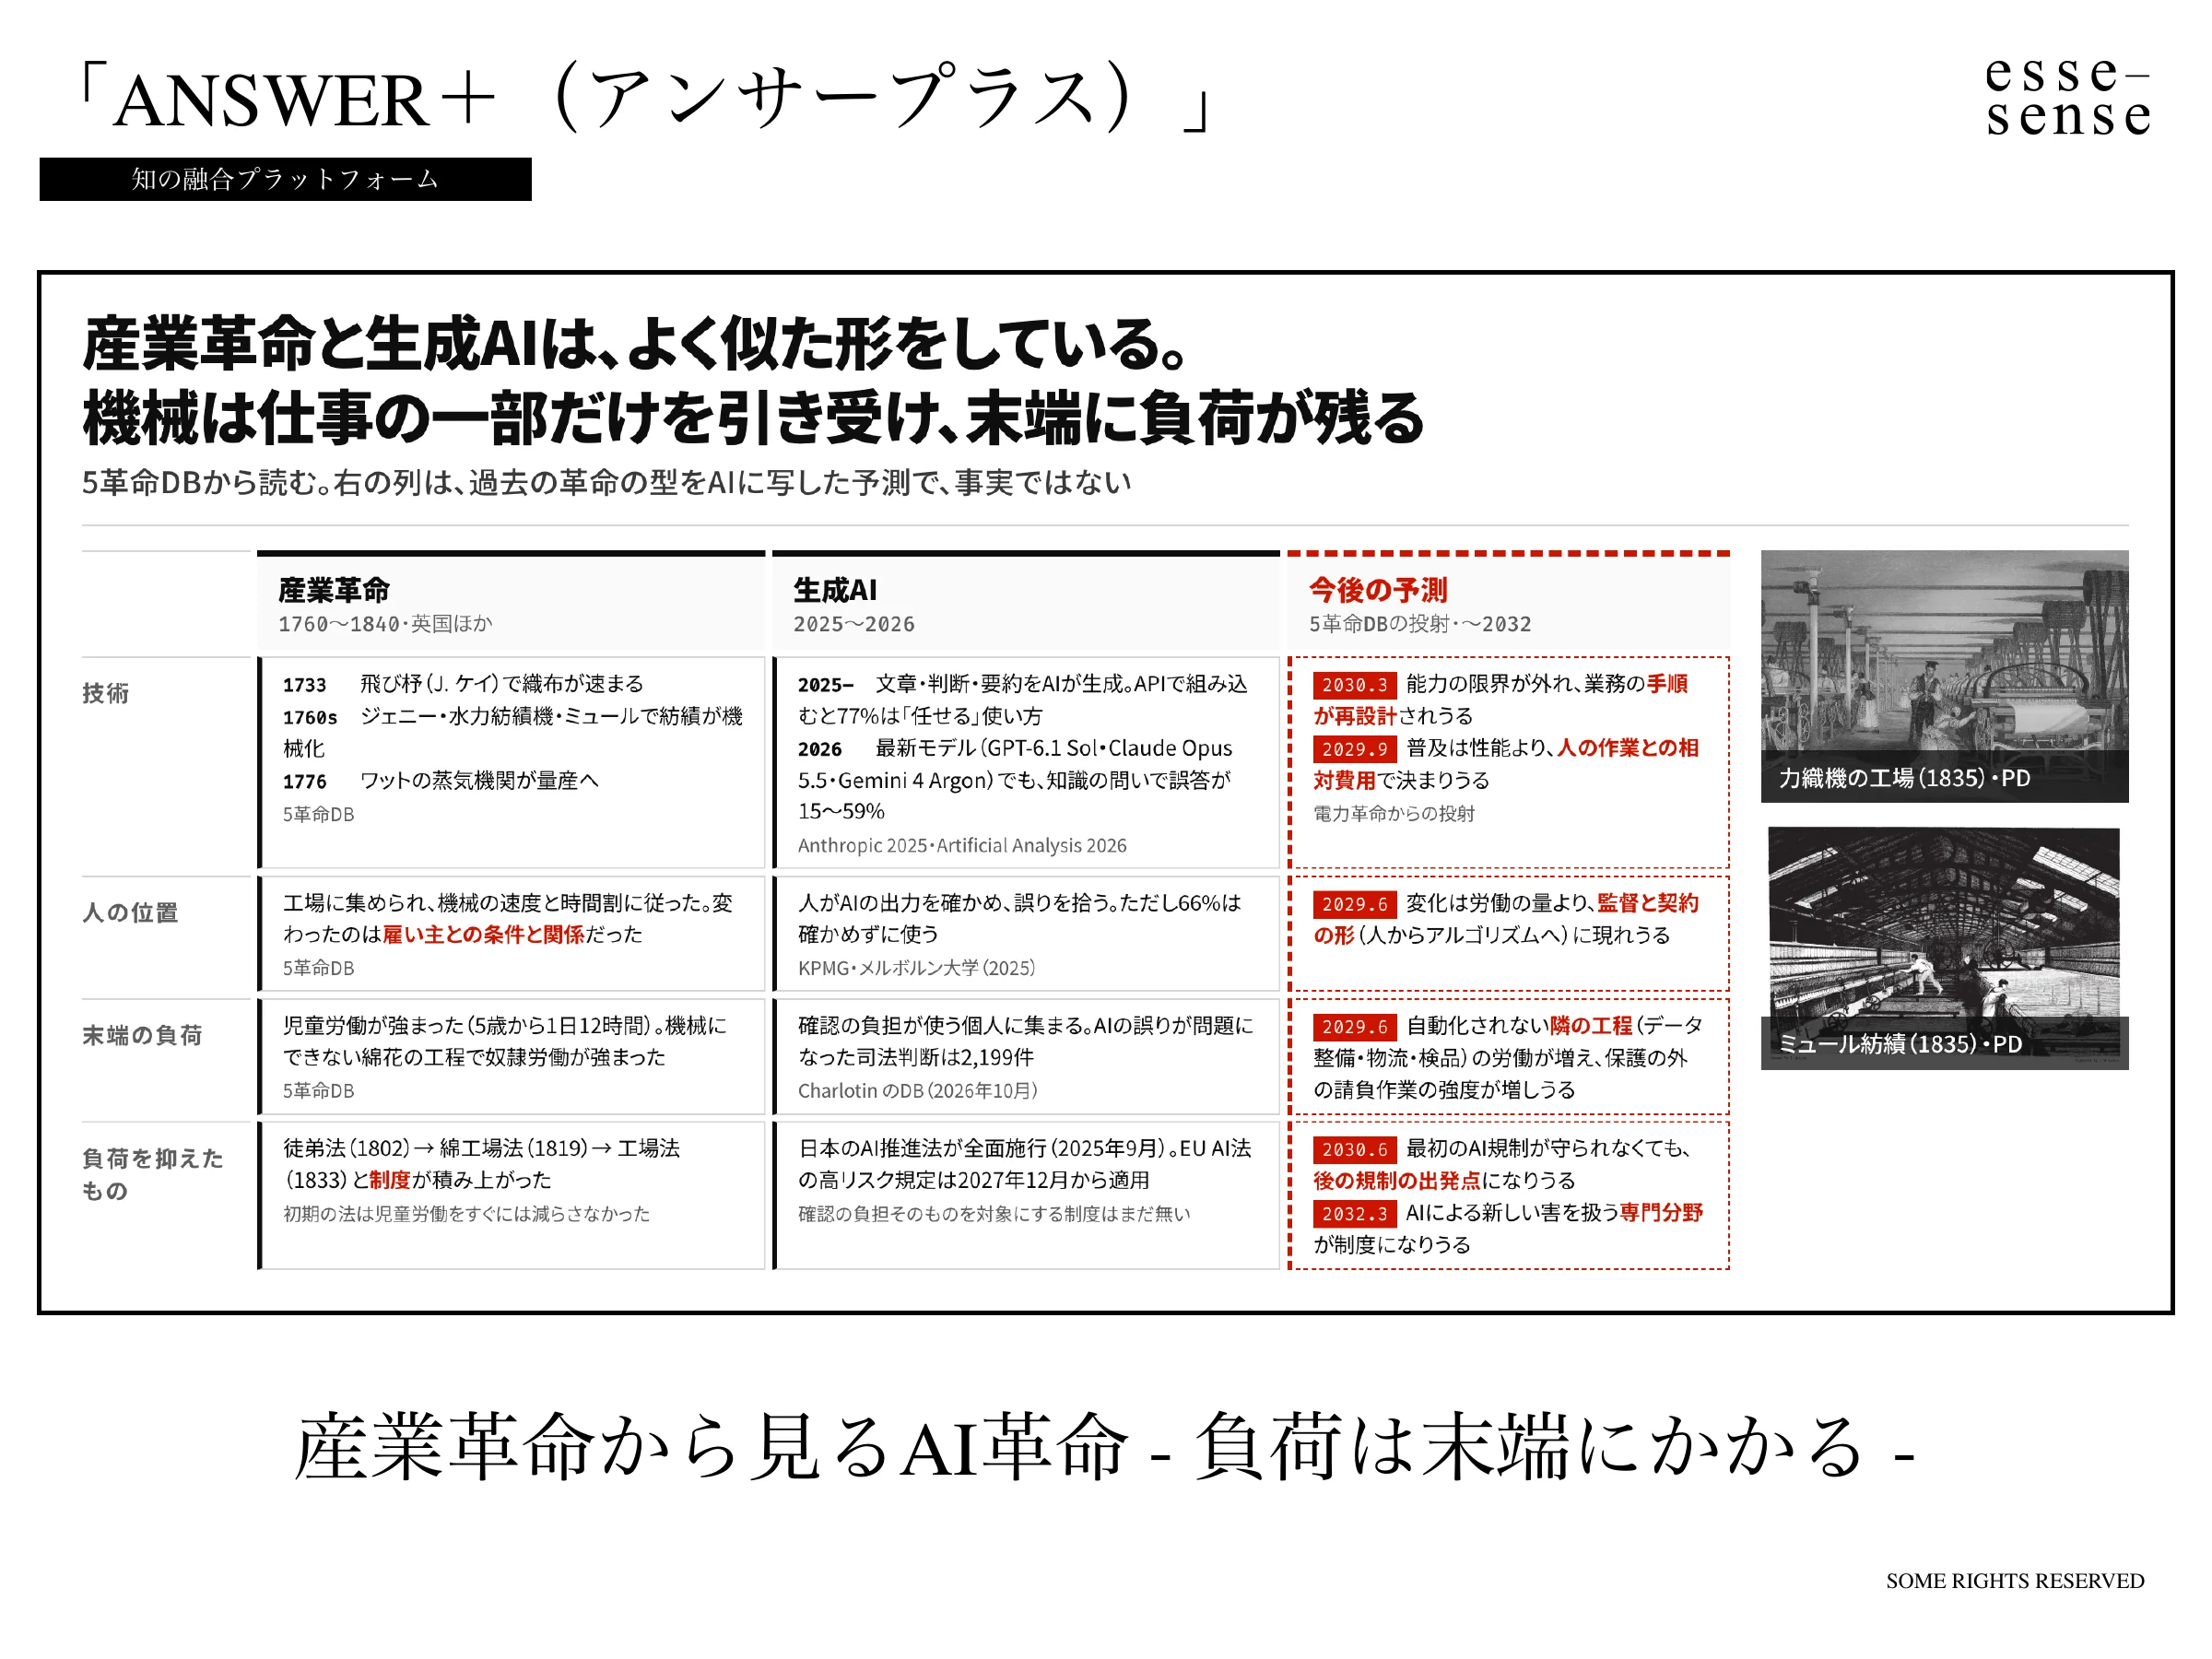
西村は、産業革命の機織りの自動化を引いた。機械は布を速く大量に織れるようにしたが、全自動になったわけではなく、各段階に自動化できない部分が残り、そこに負荷が集中したという。同じことがAIでも起きているのではないか、というのが西村の見立てである。西村はこの見立てを図で示した。AIに書かせると、確かめる、直す、間を拾う、元の資料に当たるといった仕事が増え、出力が速く多くなるほどその量も増える。隠して渡せば、その負荷が相手に渡る可能性もあるという。家庭では確かめるのに、仕事の中でシステムに組み込まれると確かめずに使う傾向があることも紹介し、これを「AIの取りこぼしを拾う新たな労働」と呼んだ。
「このAIの取りこぼしを拾うという新たな労働、この労働を、もしAIに何かを書かせてしまうと起こしてしまっているんじゃないか」 ― 映像 19:22 の発言
03 ANSWER+の仕組み
いきなり書かず、先に素材を引いてから書く
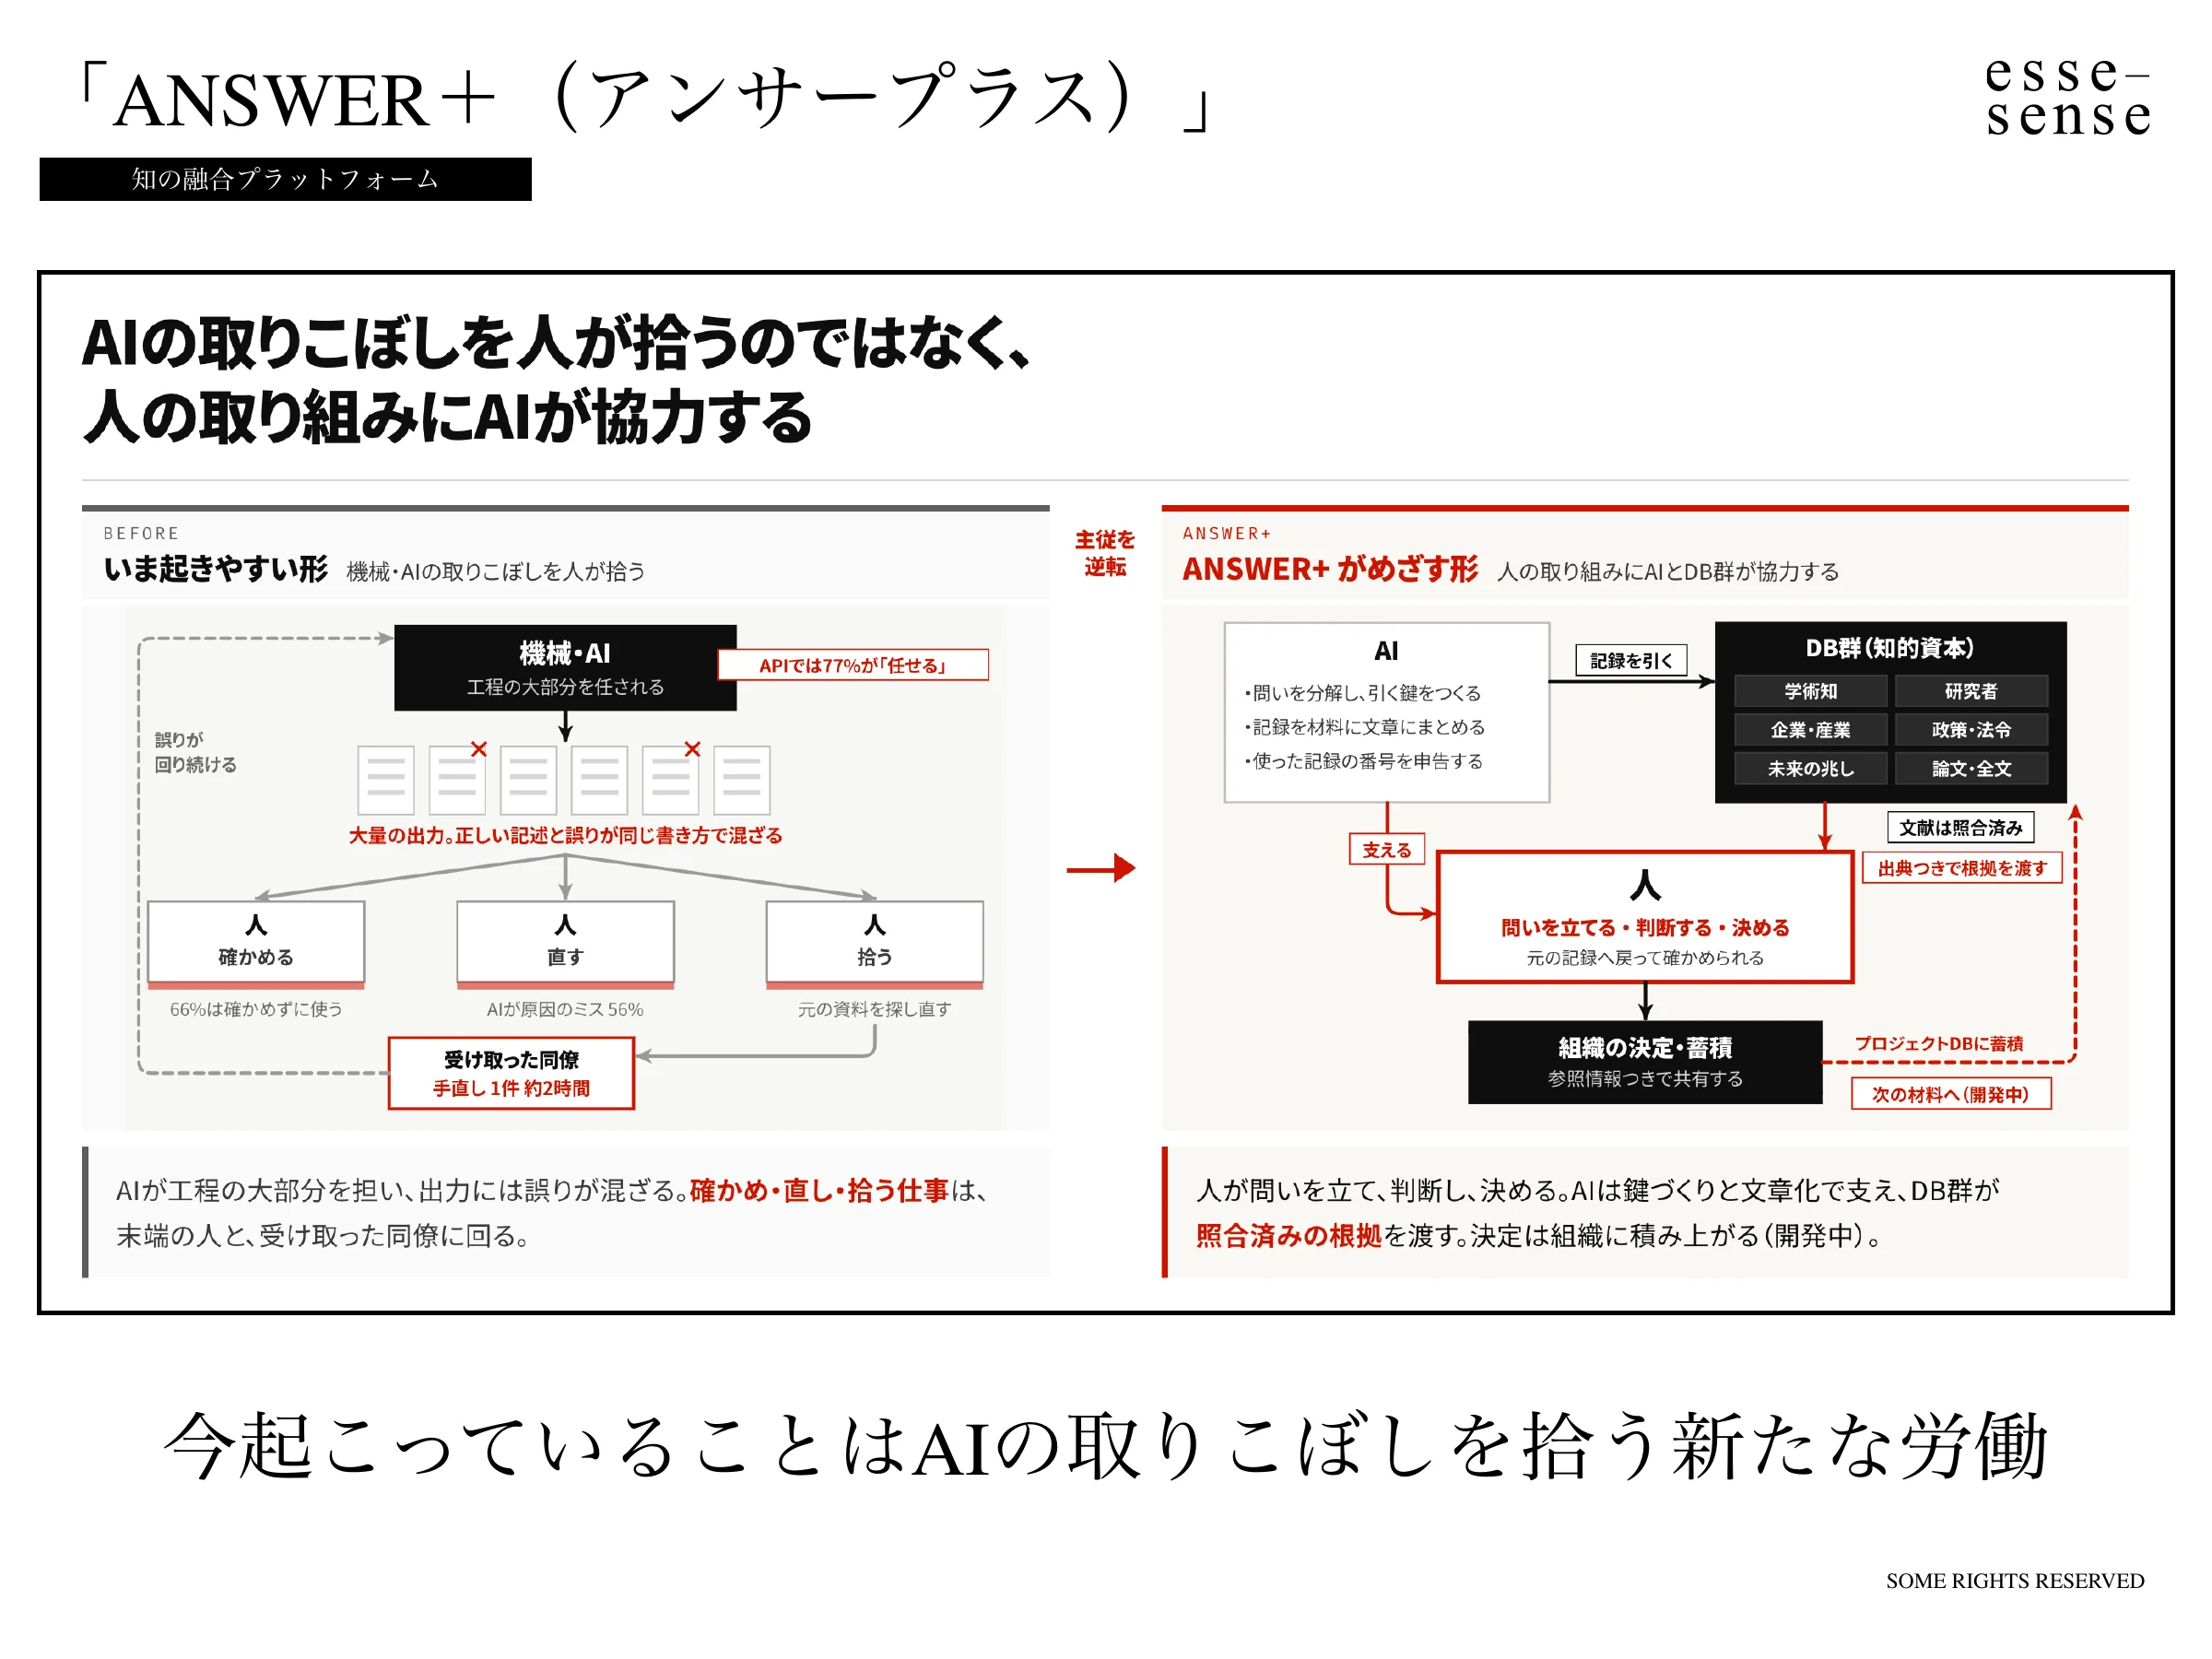
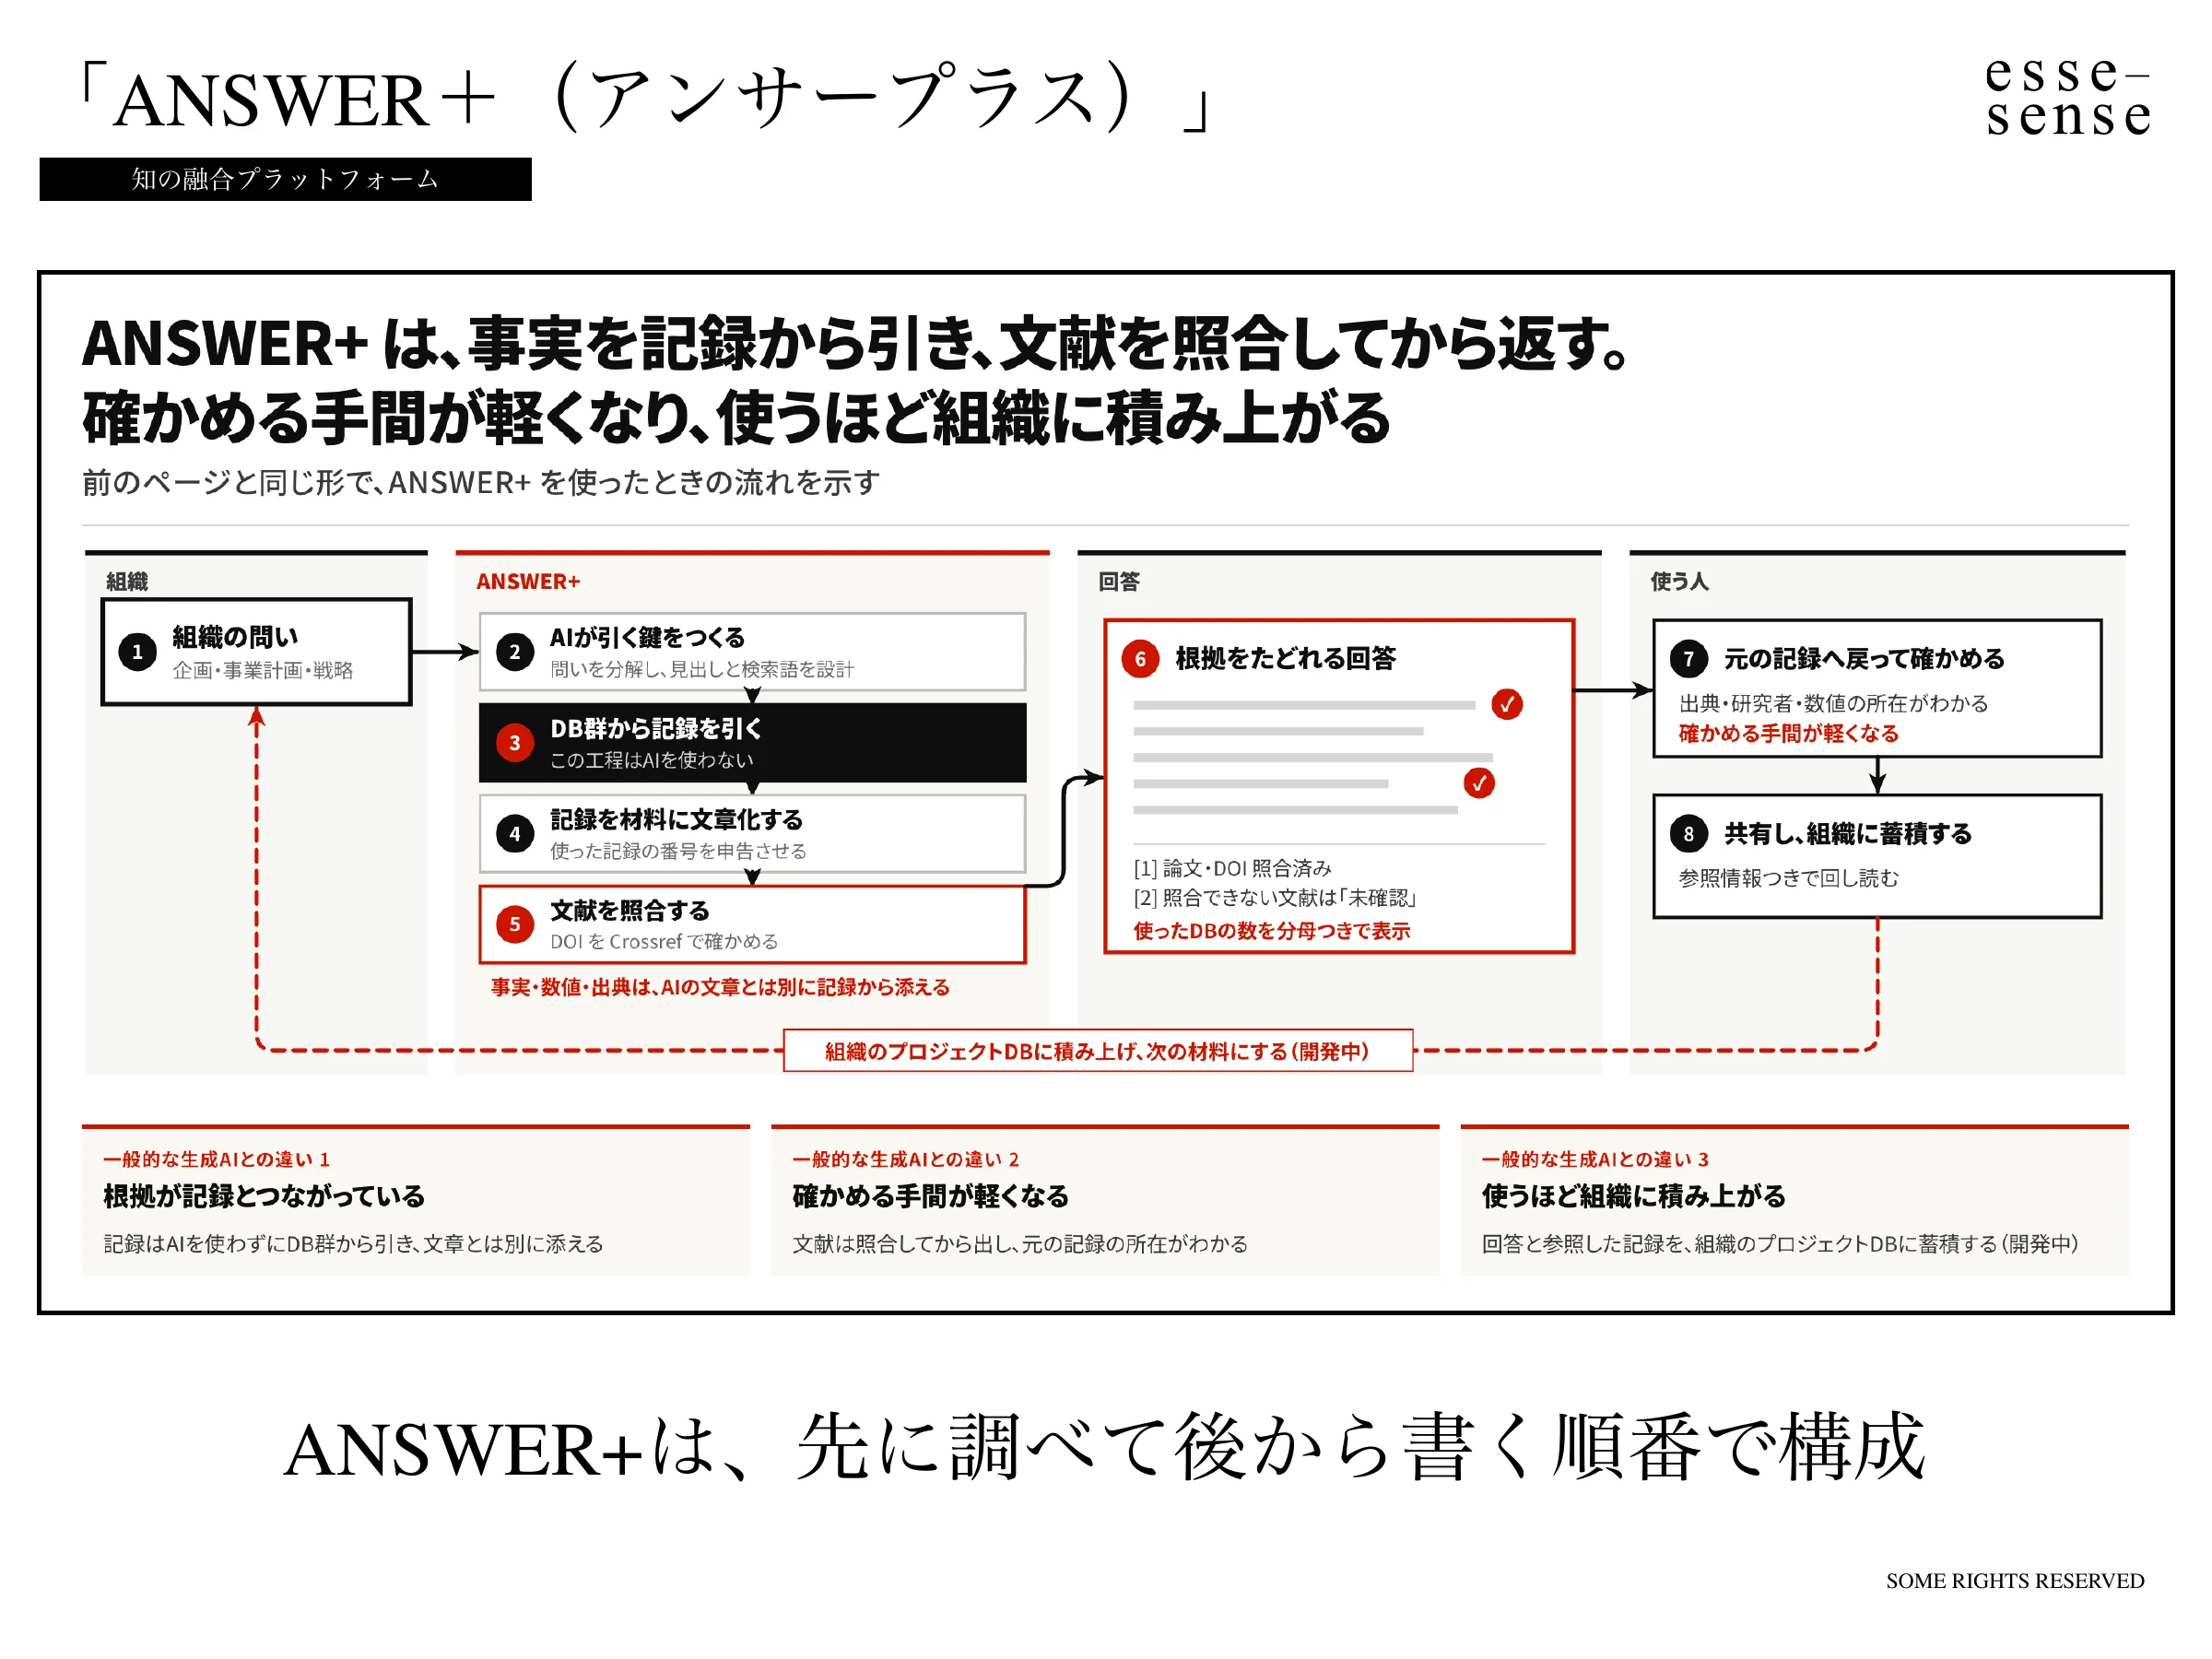
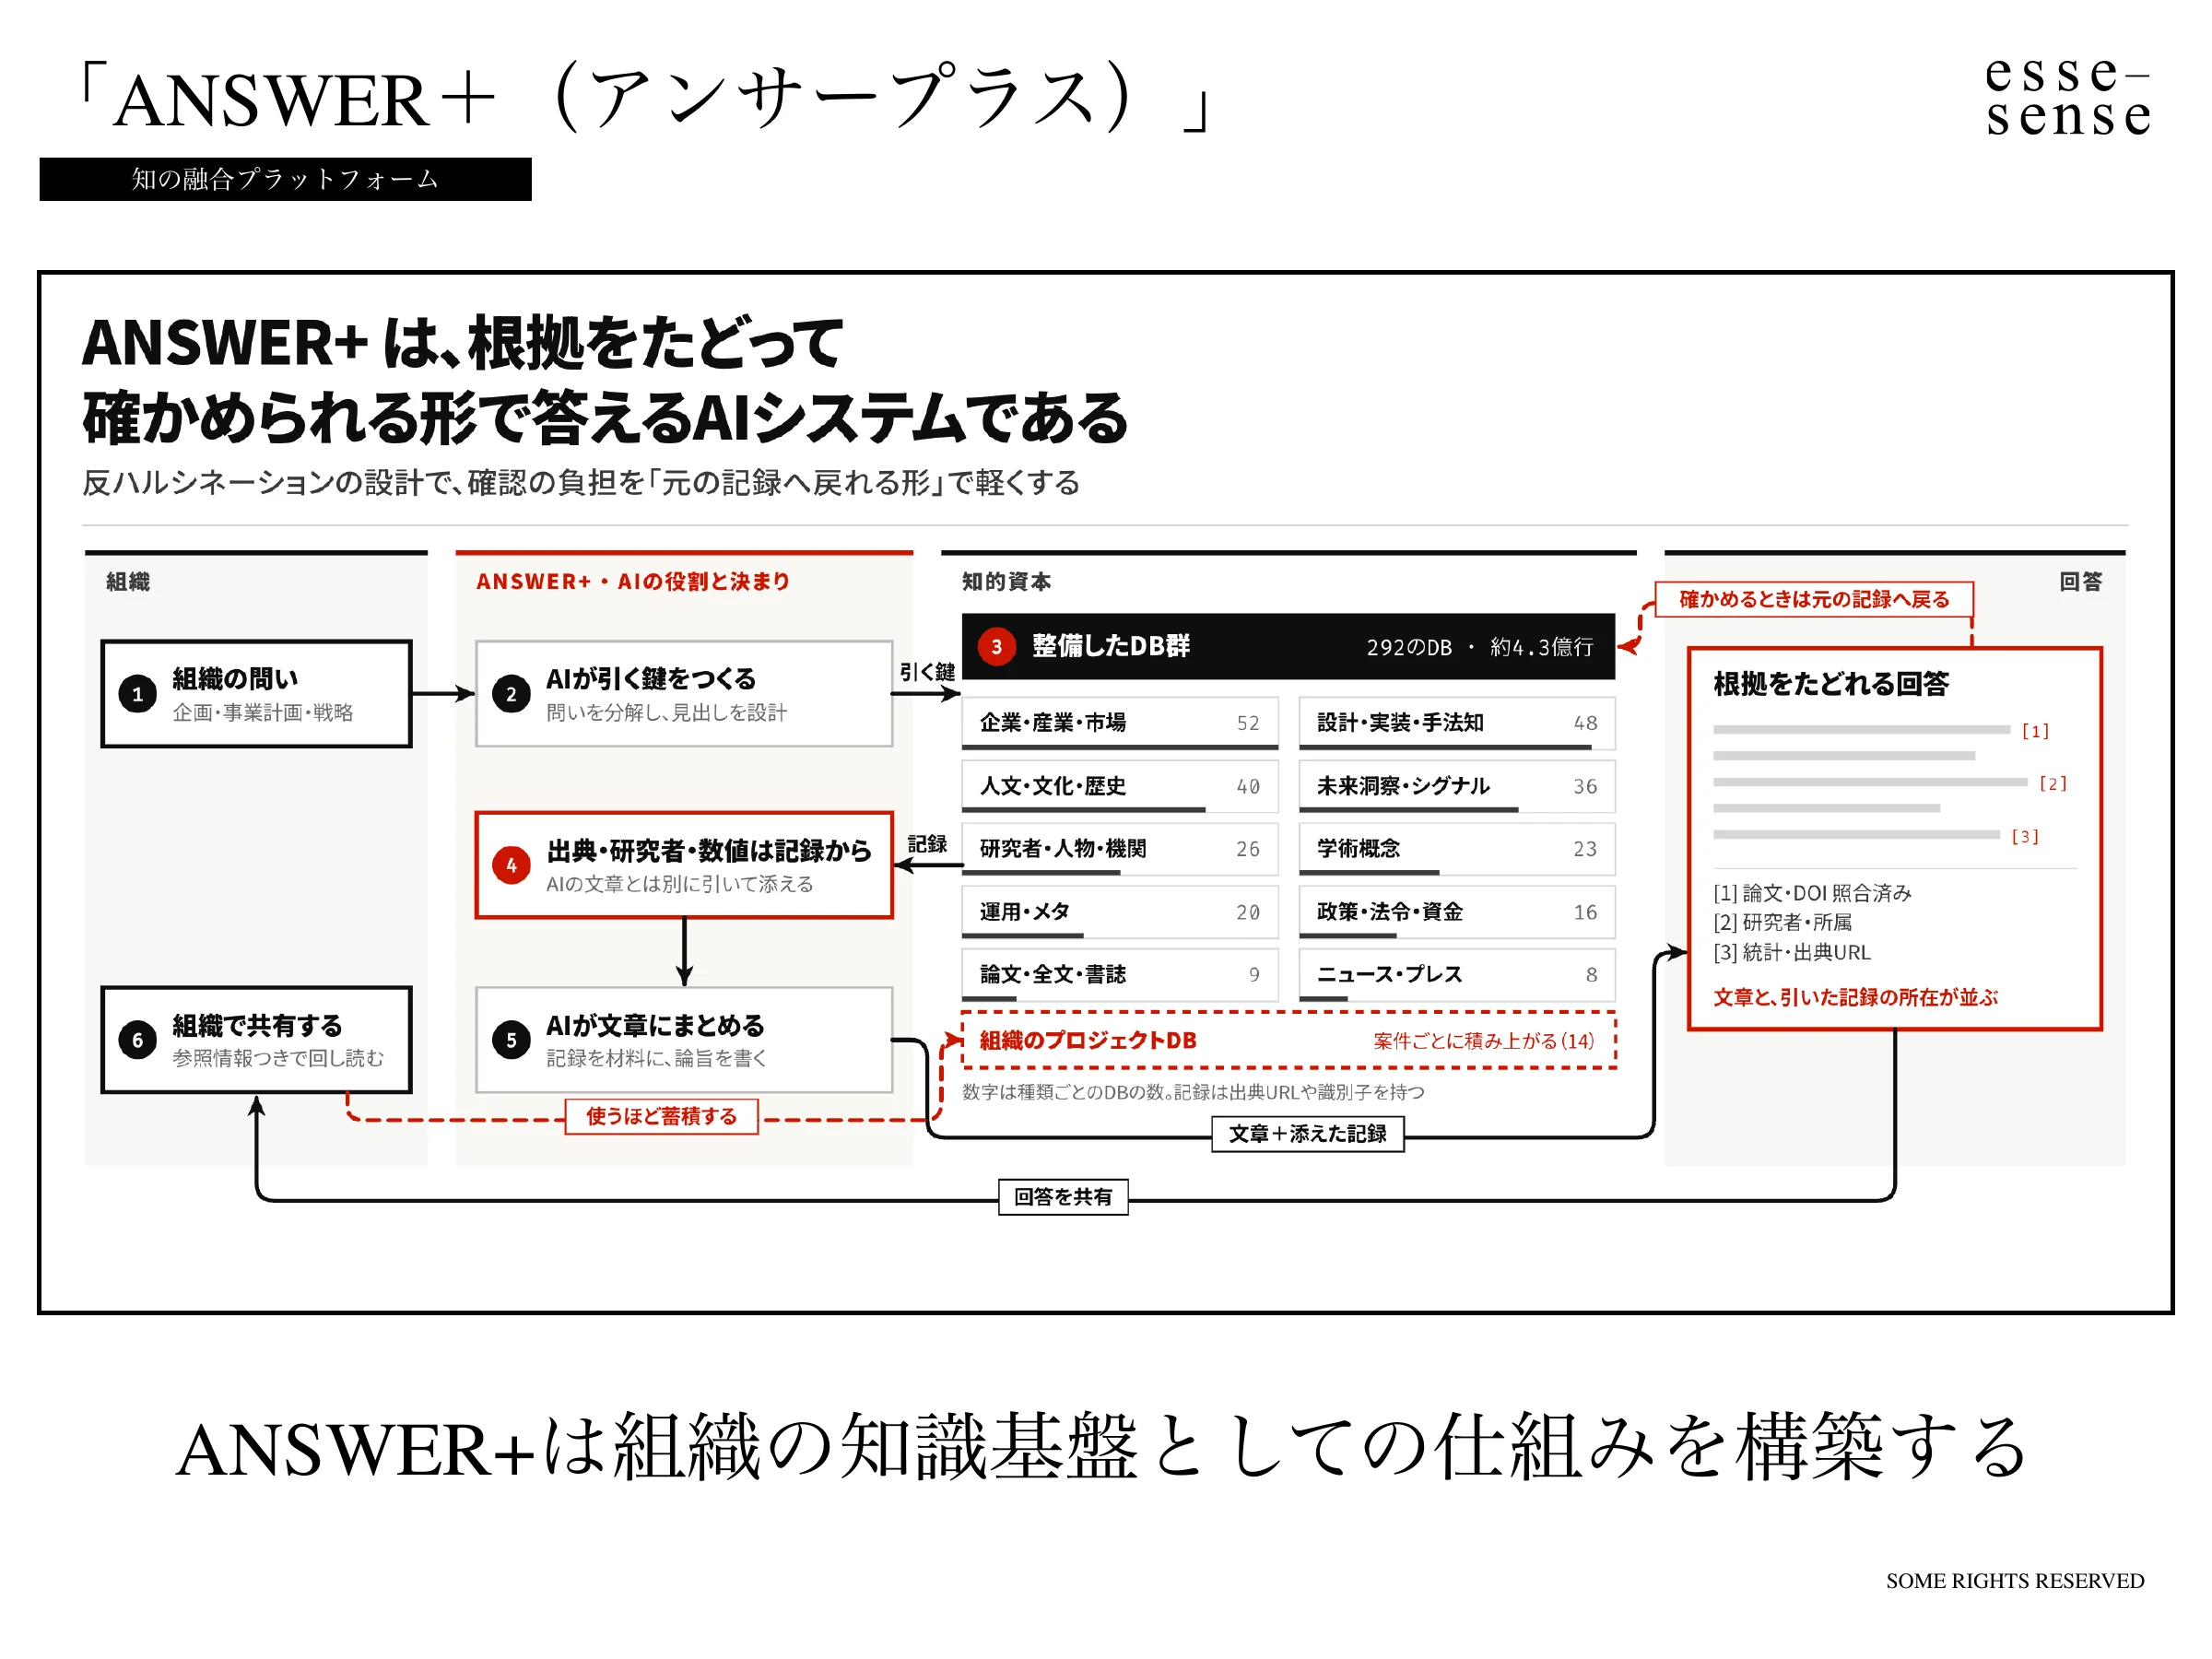
西村は、一般的な生成AIでは、問いを受けるとすぐに文章を作り、使う人が確認して次の問いへ戻る、という回転を繰り返していると説明した。その結果、根拠と記録がつながらず、確かめる手間が人に残り、組織の学習も進まない。ANSWER+は順番を変える。問いを受けたAIに、事前に準備したデータベース群から記録を引き出させ、その素材をもとに文章を作り、文献が確かに存在するかを検証して、根拠をたどれる回答を作る。AIが書くのは、引いた素材の間をつなぐ部分に限られる。元の記録にいつでも戻れるので確かめる手間が減ると西村は述べた。出てきたテーマや回答を次のプロジェクトの材料として戻すサイクルは開発中だという。
「いきなり文章を作らないわけです。まずは素材を探してくださいと」 ― 映像 26:39 の発言
04 ANSWER+のソリューション
AIを、人が考えて判断するための支え役に置き直す
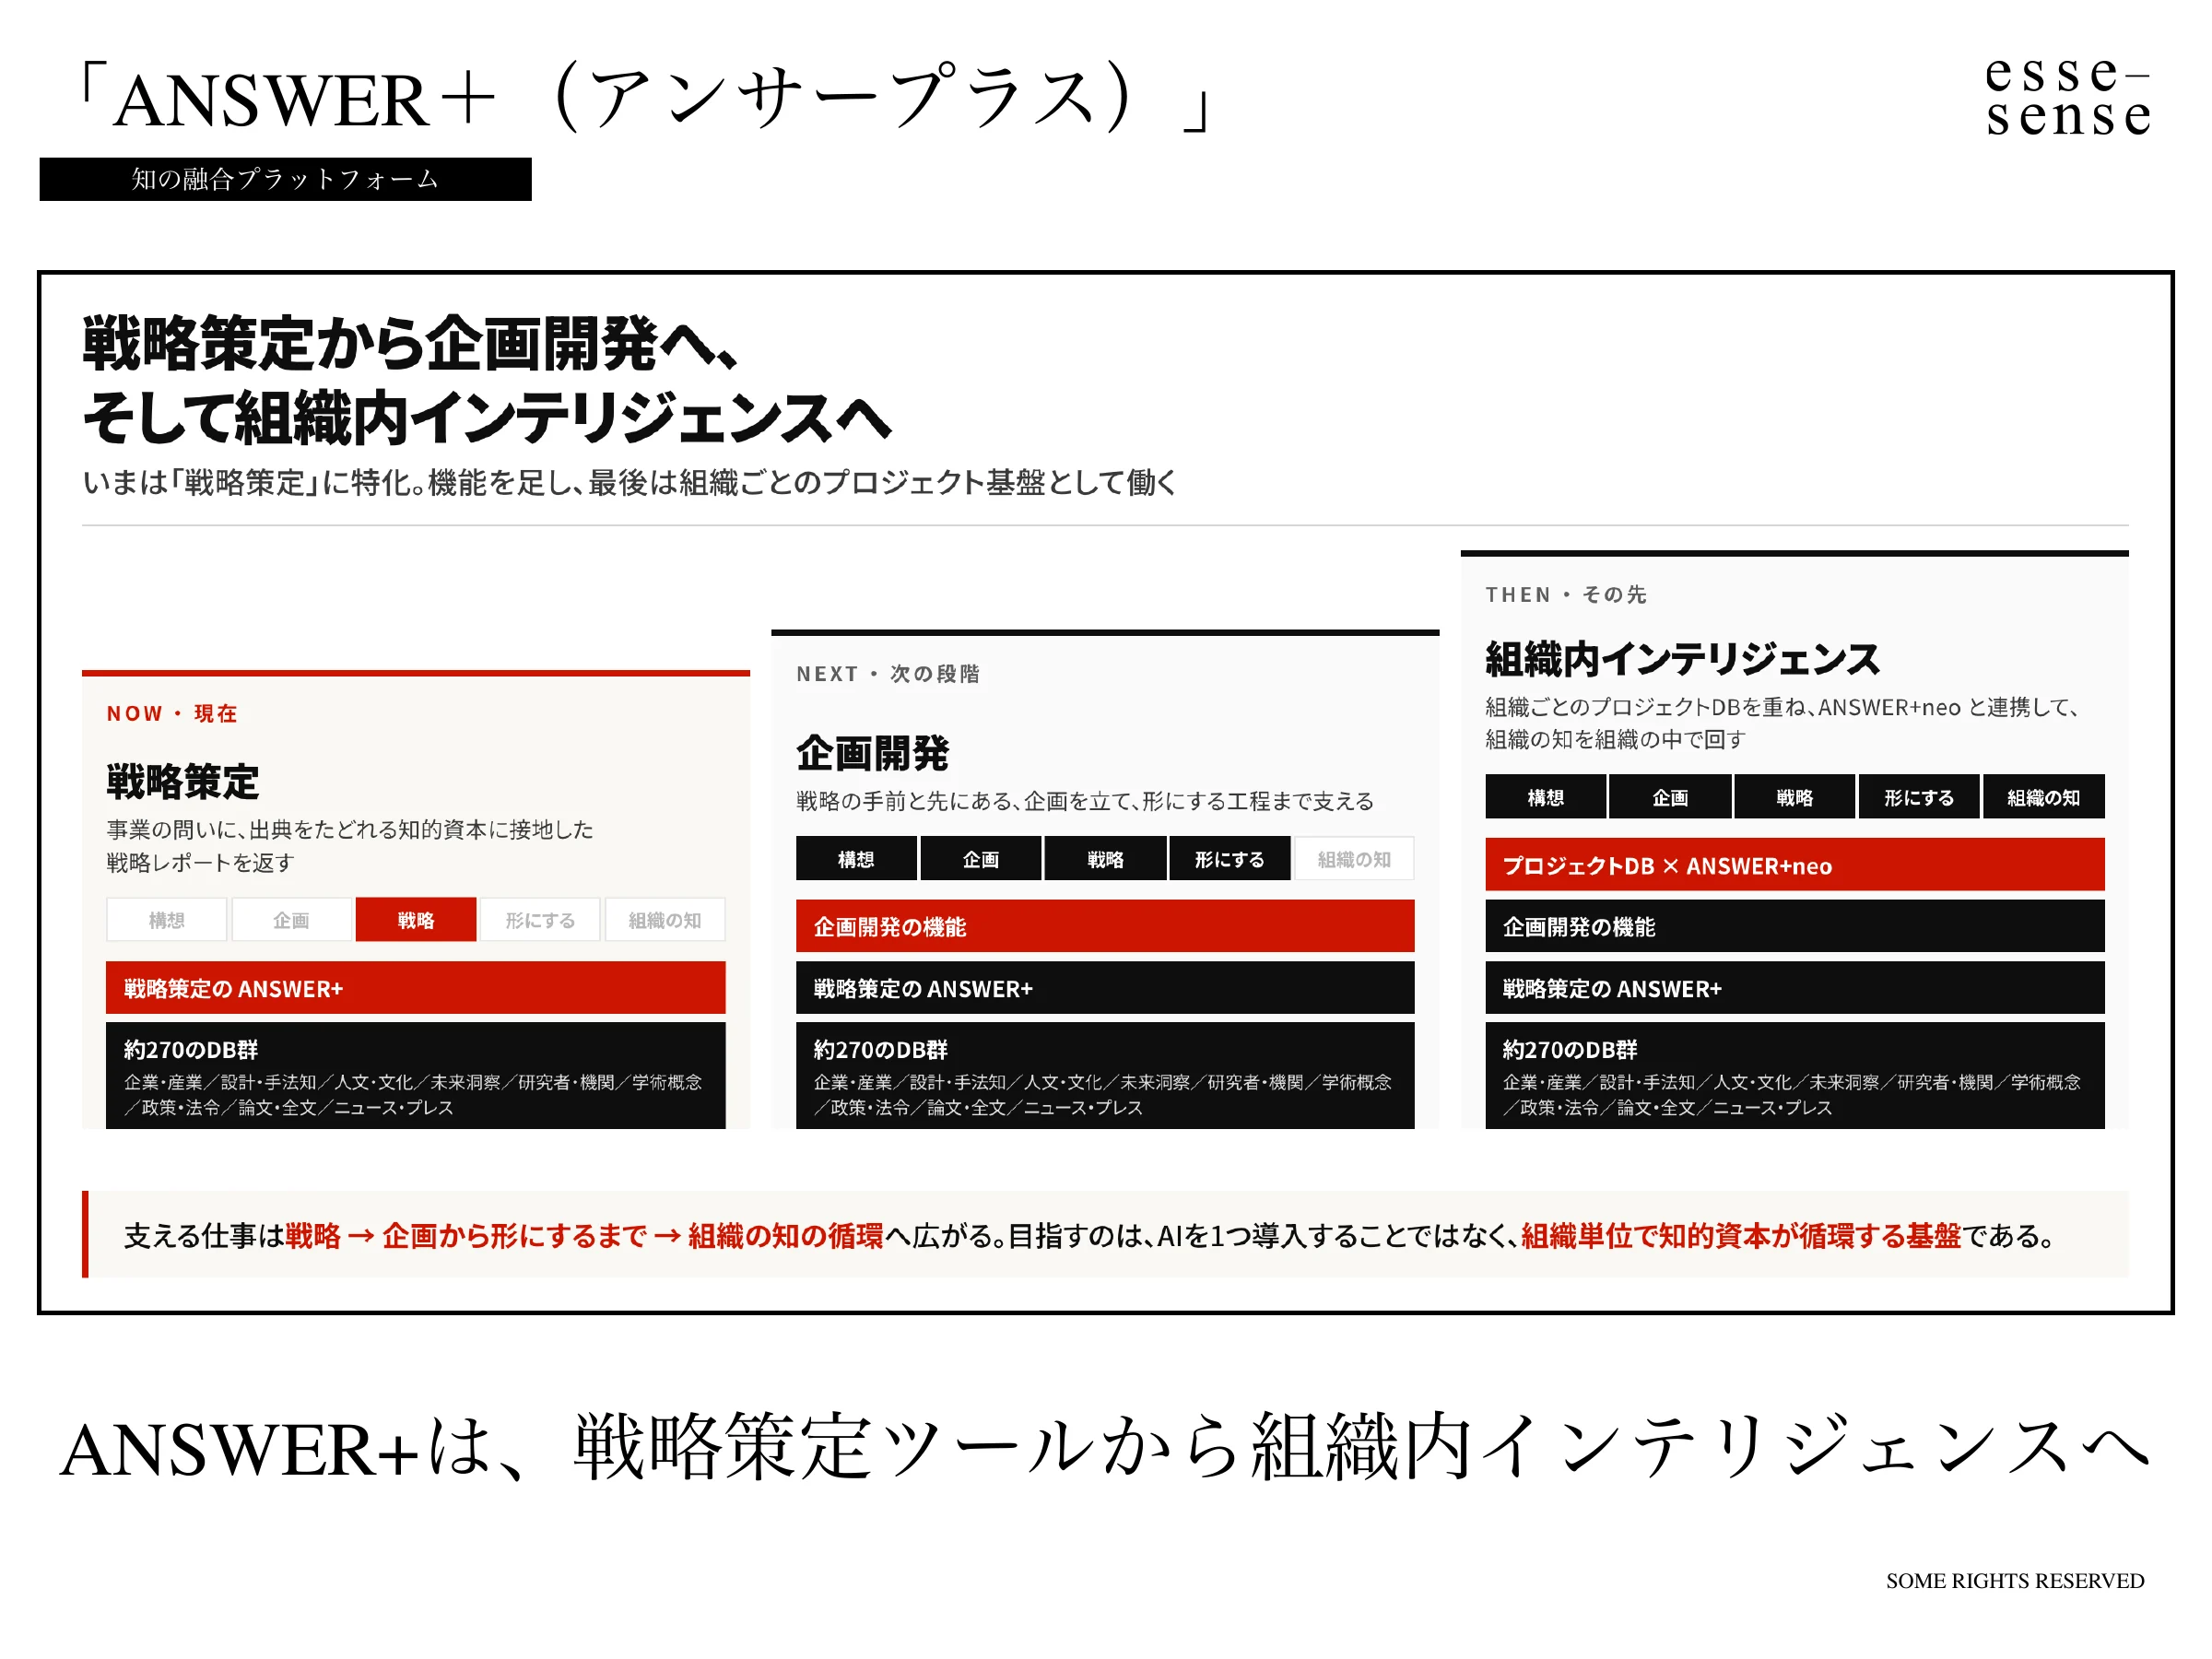
後から確かめ、直し、資料を探し直すのなら、先に確かめて直し、資料が紐づいたものを作ってしまえばよい。西村はこれを「たったそれだけのこと」と言う。検証済みで参照元が分かる情報群から記録を引くことをAIの役割にし、人が考えて判断して決めていくための支え役へと主従を逆転させる。ハルシネーションと、AIが取りこぼした労働を人が引き受ける負荷という2つの課題をなくすための仕組みだと説明した。現在は戦略策定のための仕組みとして提供している。データベースの十分さが企画開発にも答えられる水準まで上がってきたため、開発中の次のバージョンでは、より広い範囲に回答を当てていくという。組織ごとに必要な情報をプロジェクト専用のデータベースとして基盤に組み合わせる仕組みは、年内の提供を目指して開発中だと述べた。
「実は全く逆でAIに書かせないための仕組みとして開発をしてきました」 ― 映像 34:45 の発言
05 292のDBから引く仕組み
292のデータベースを、量でなく「十分さ」で組む
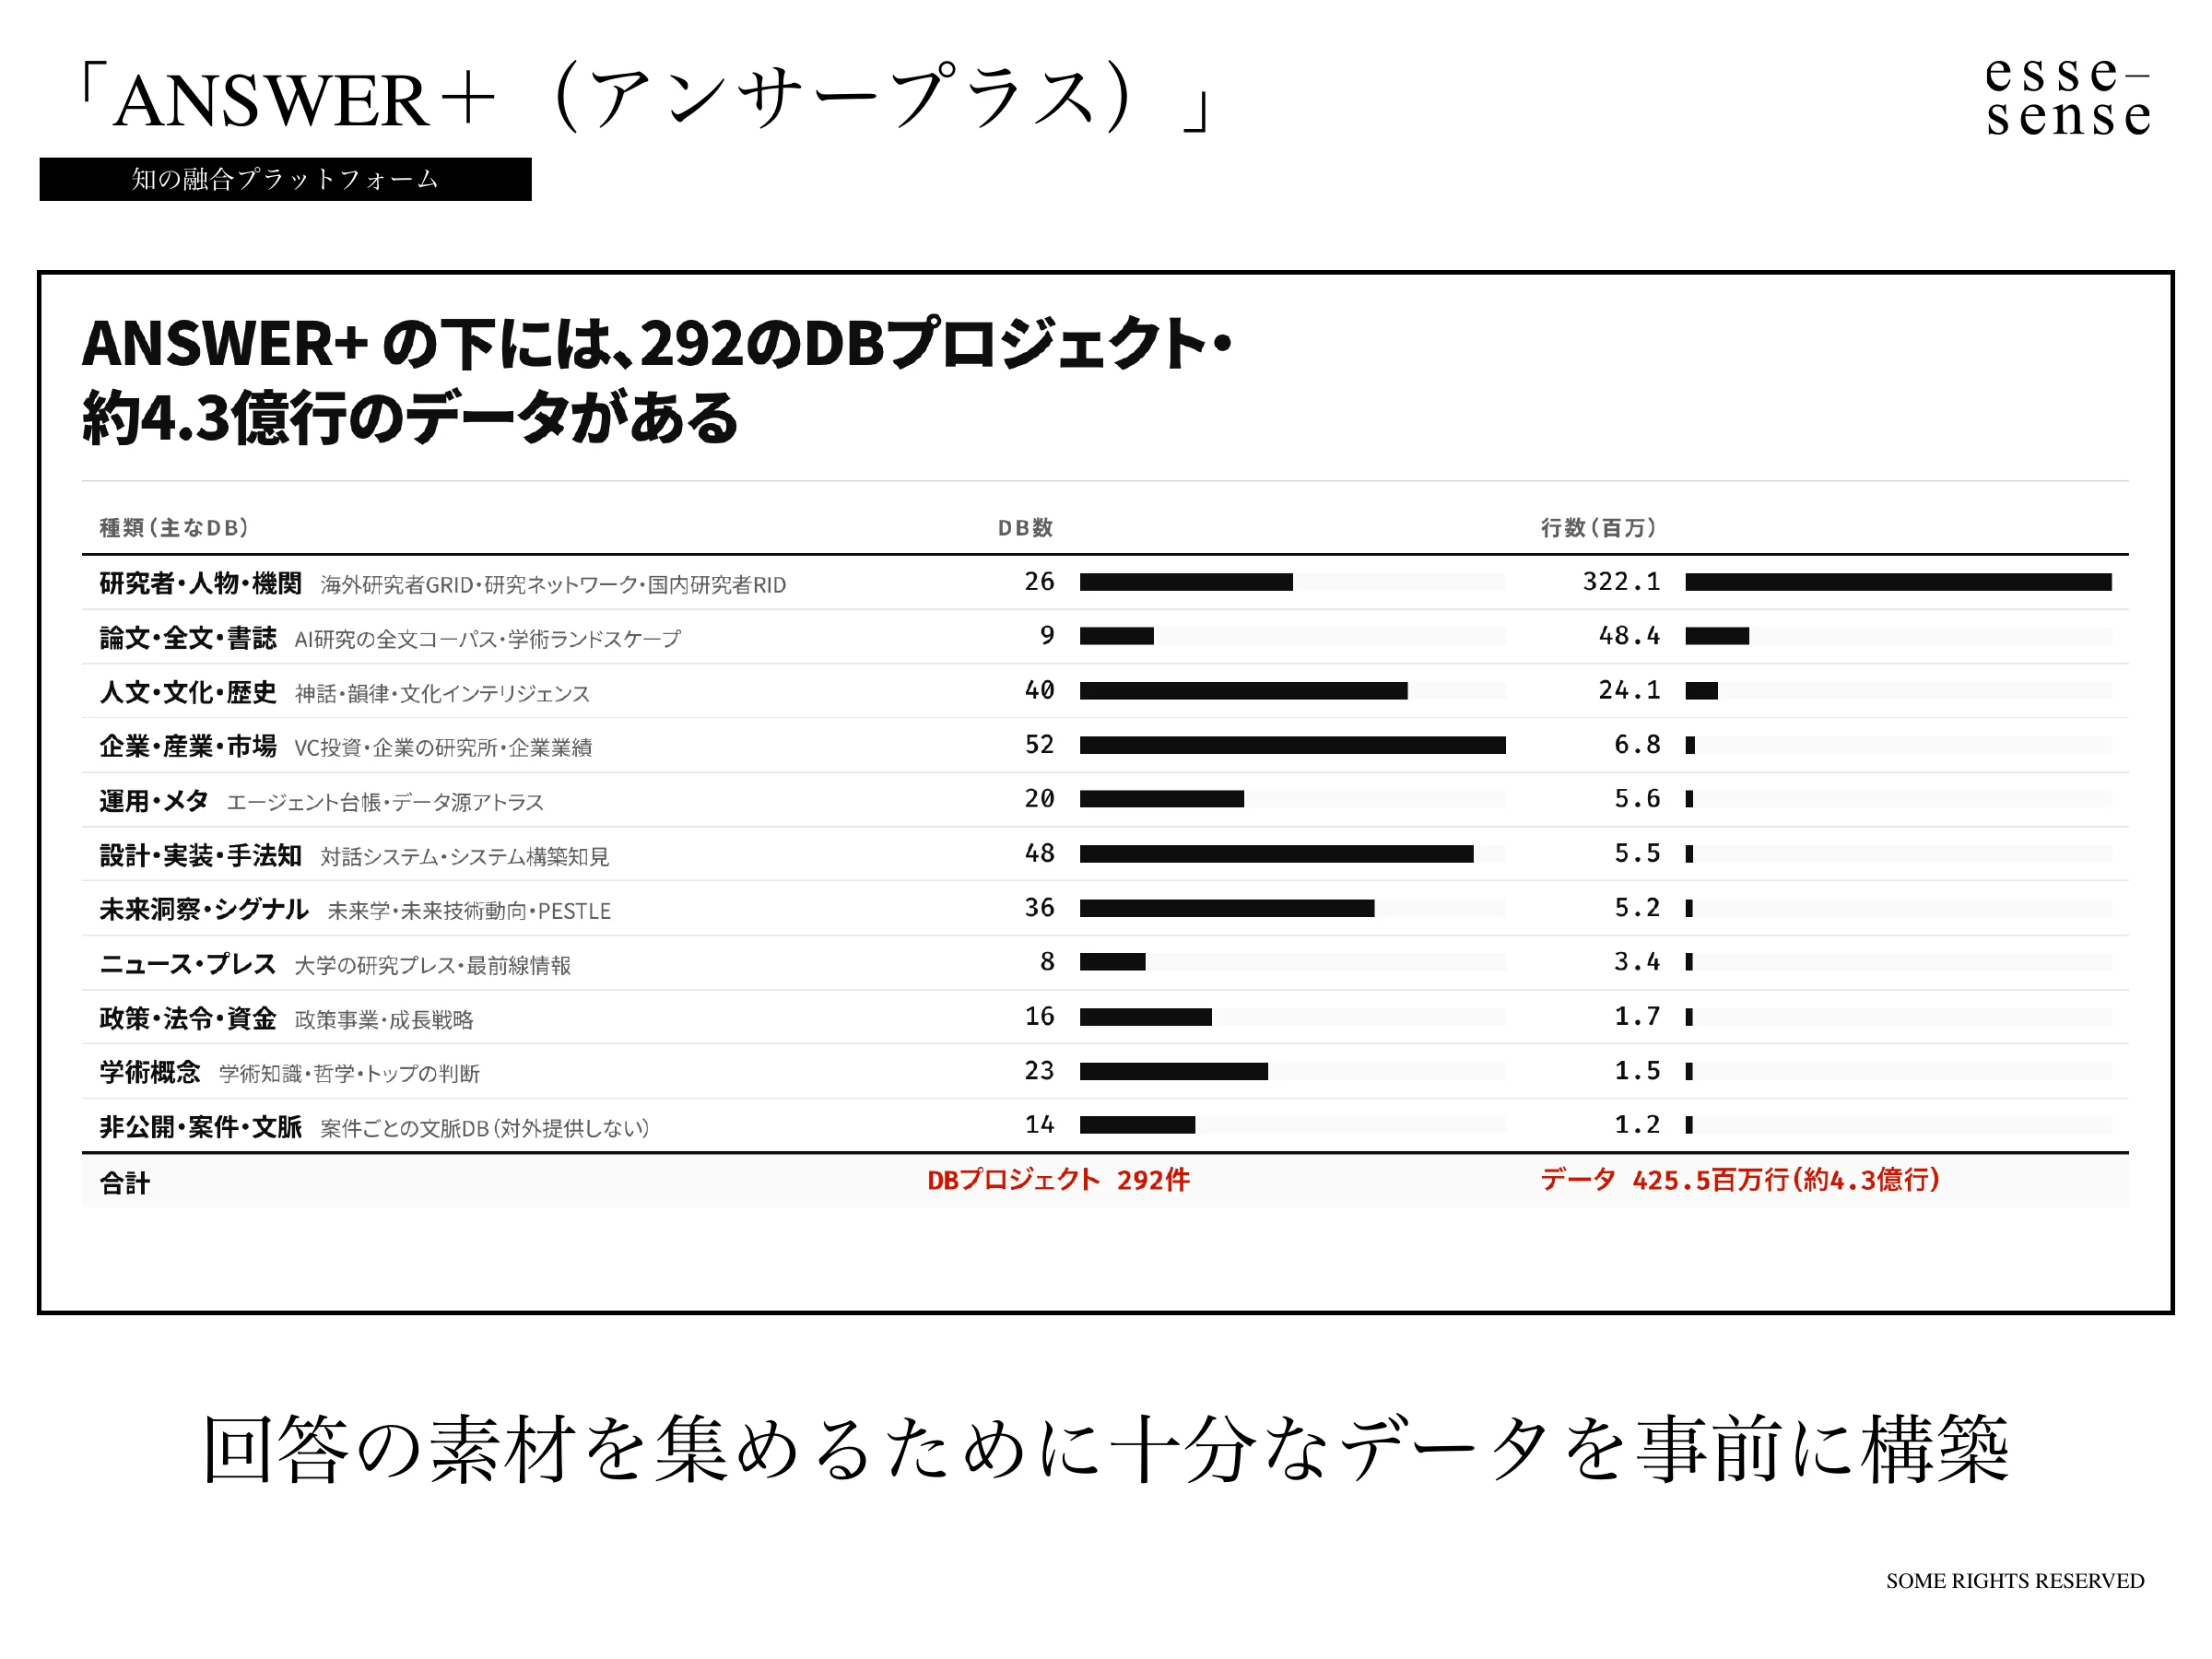
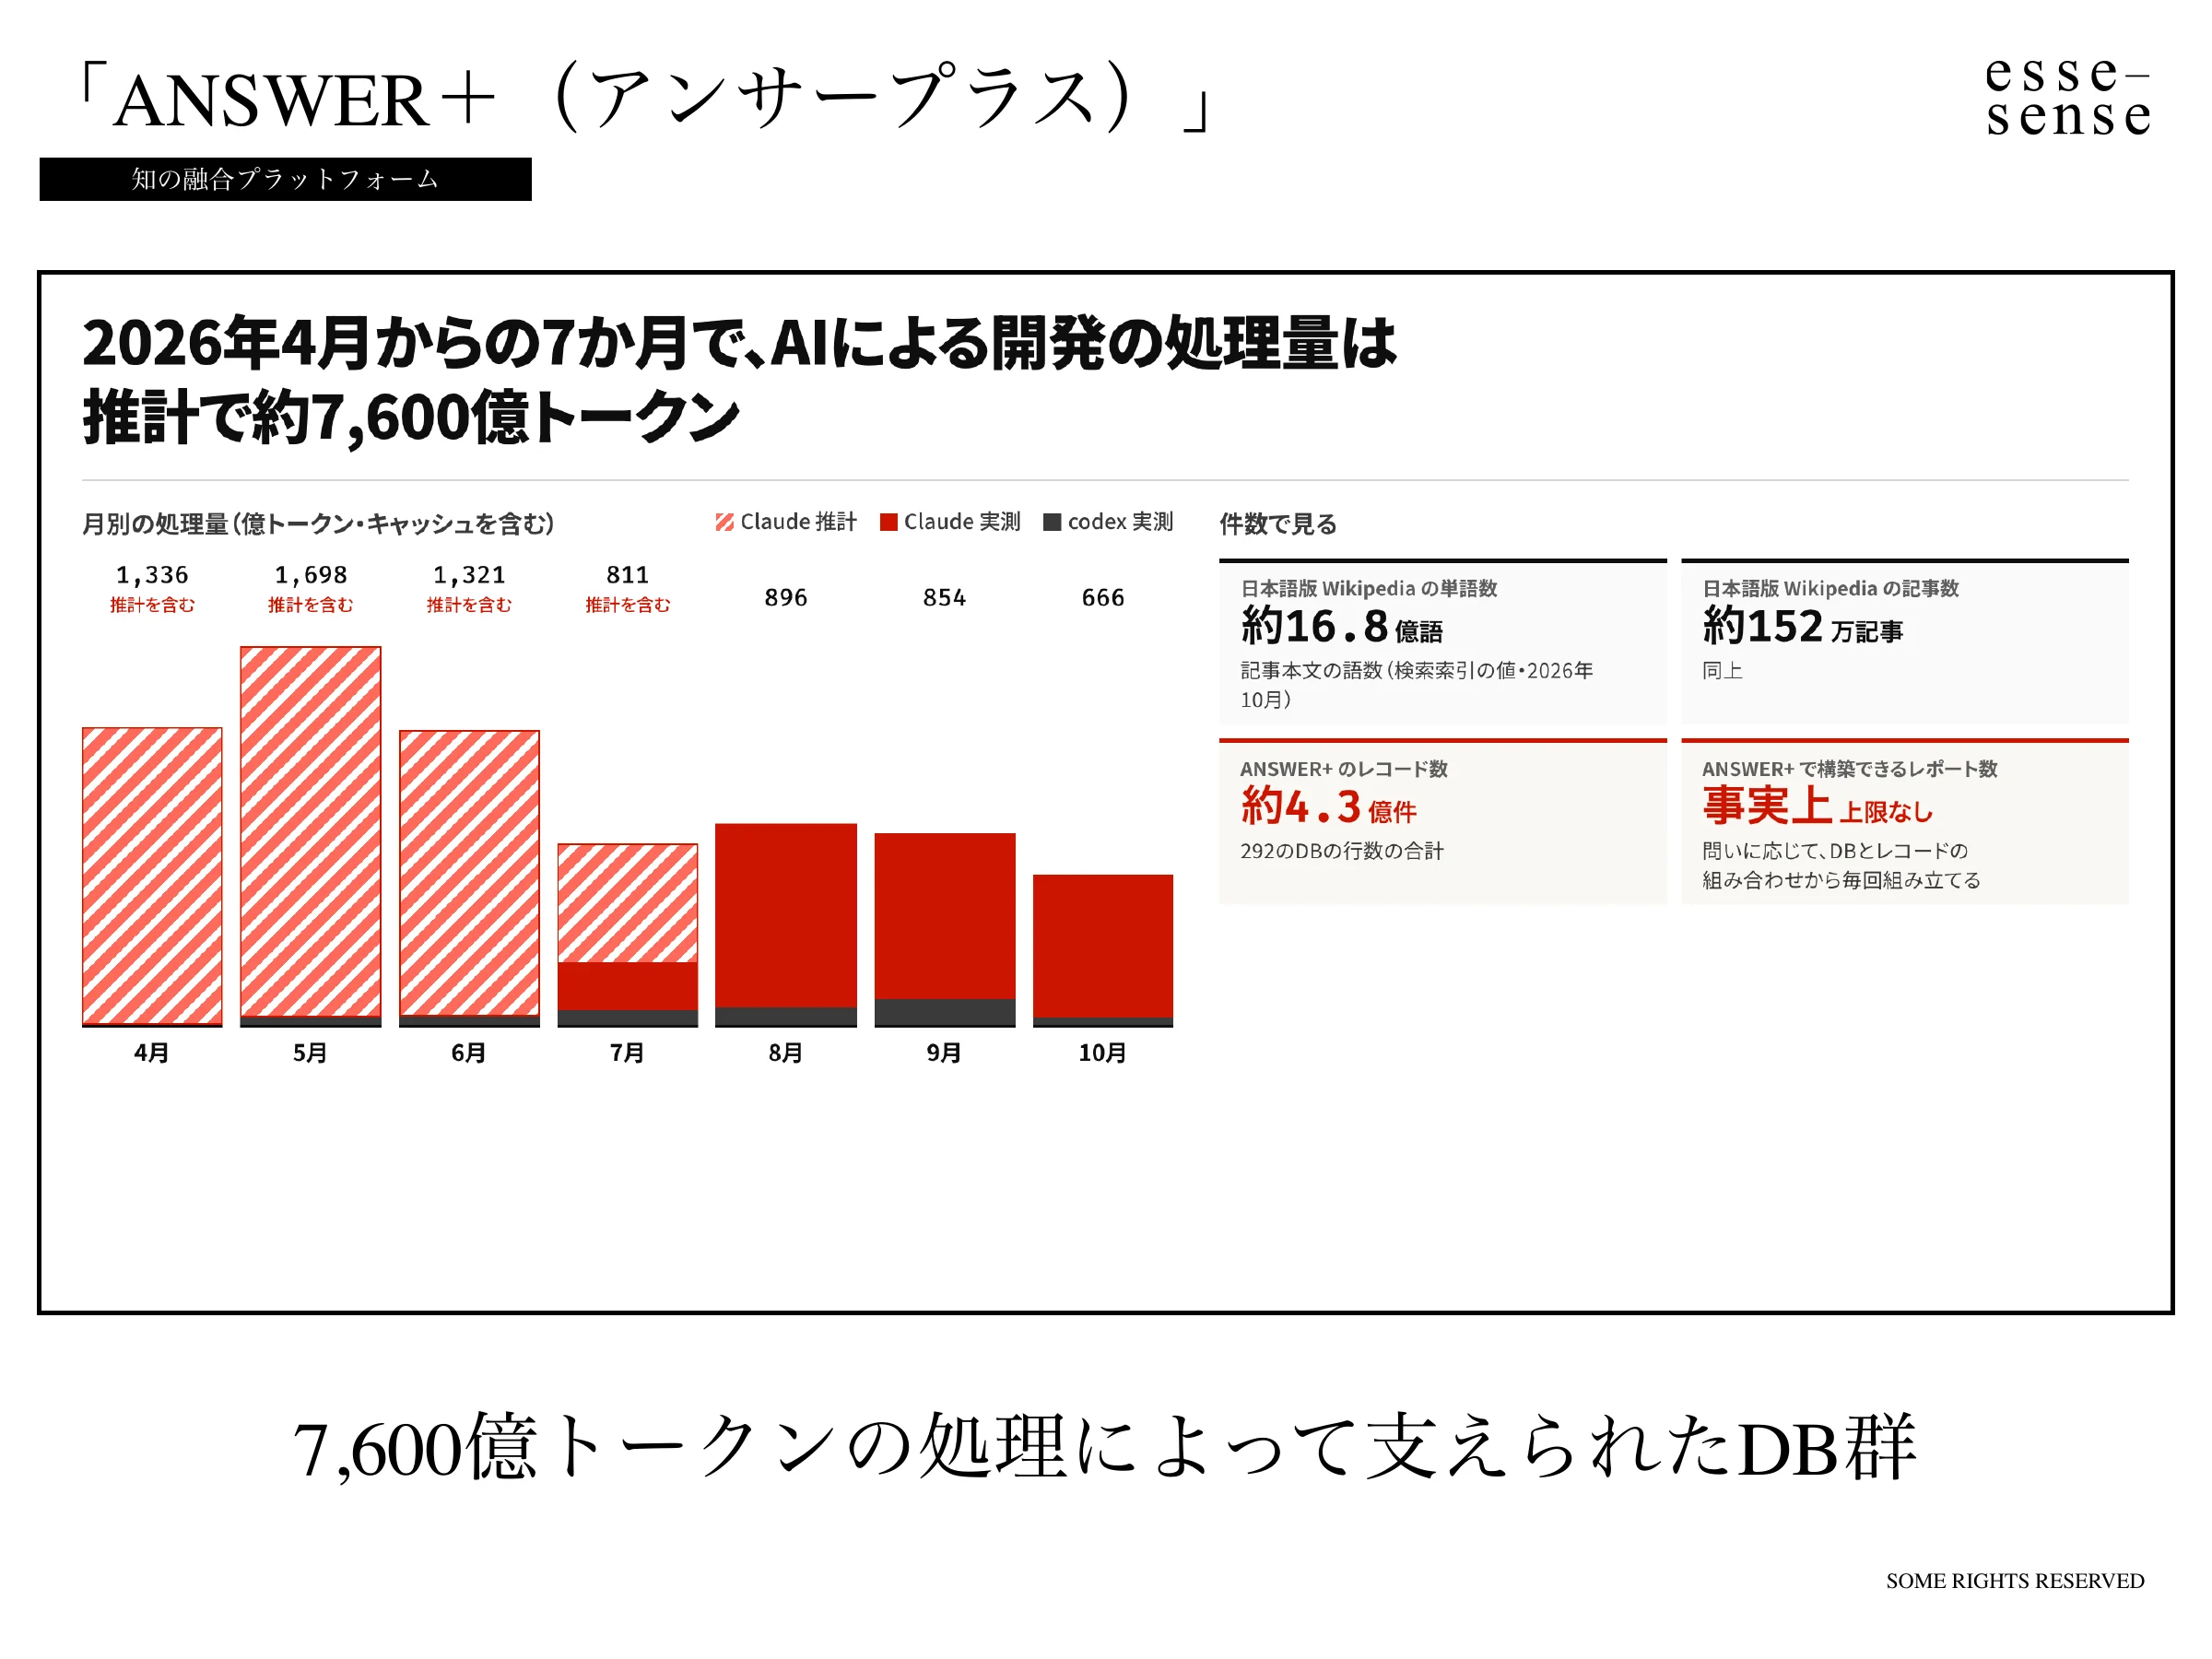
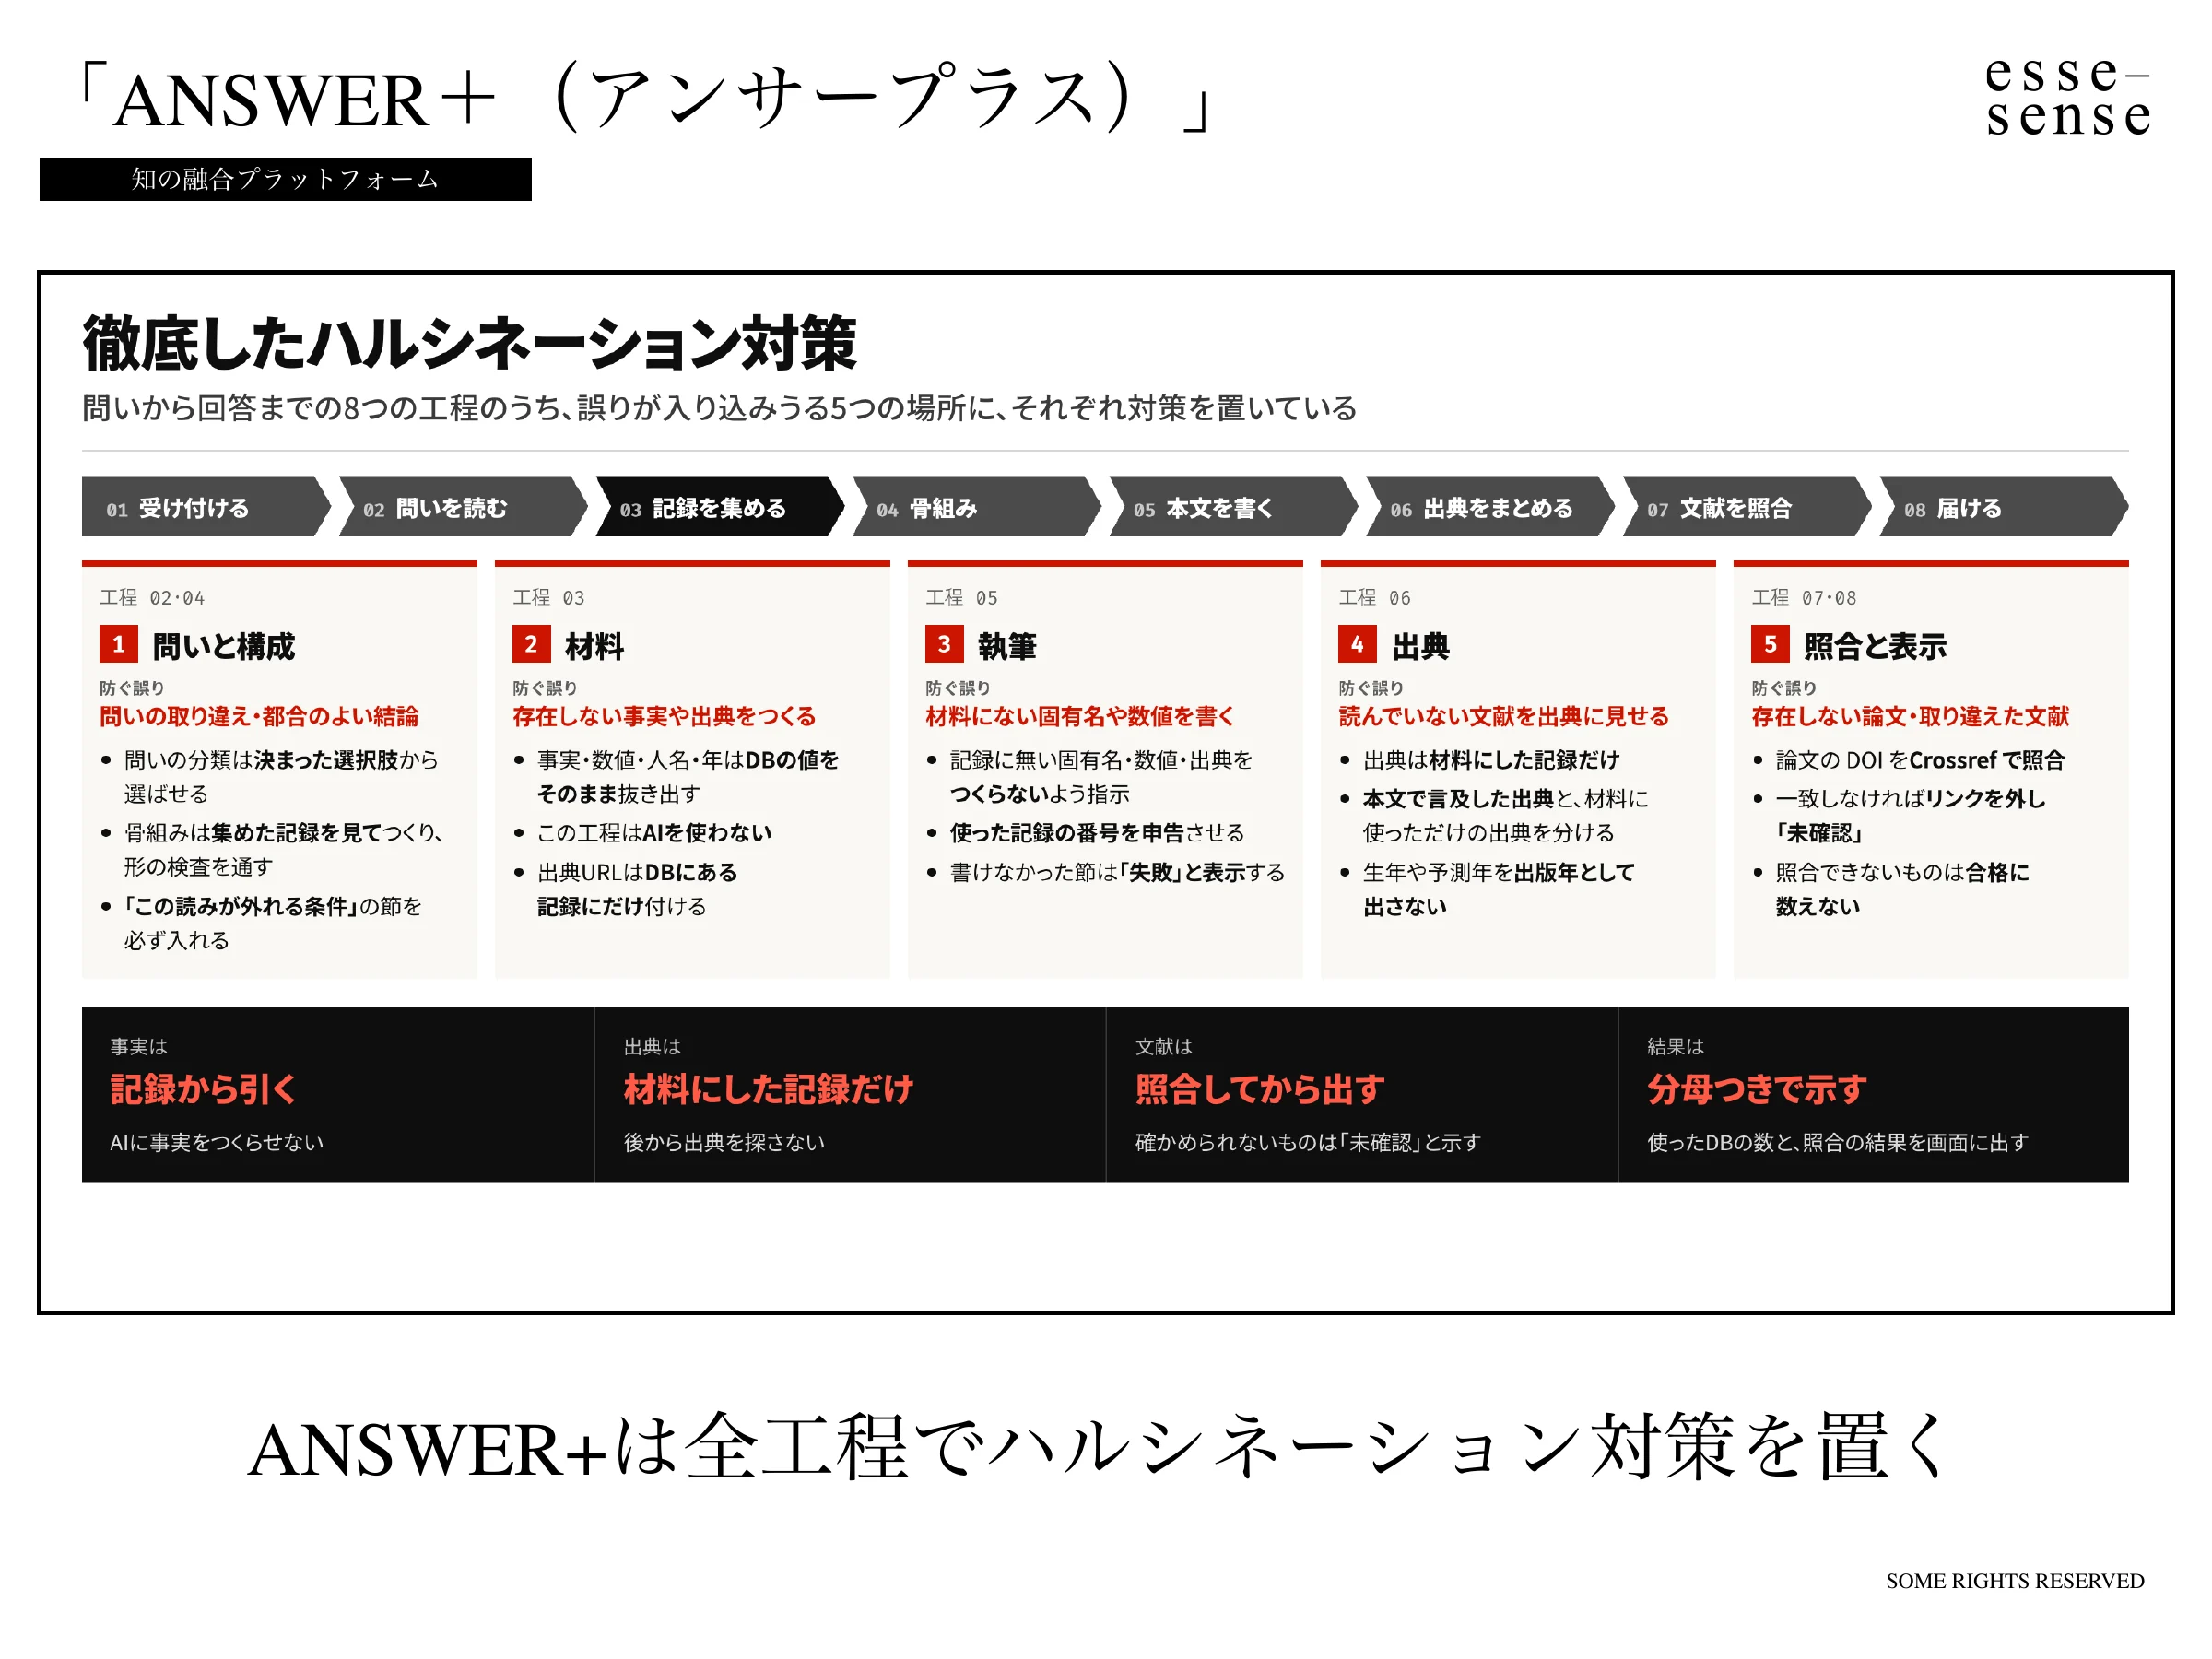
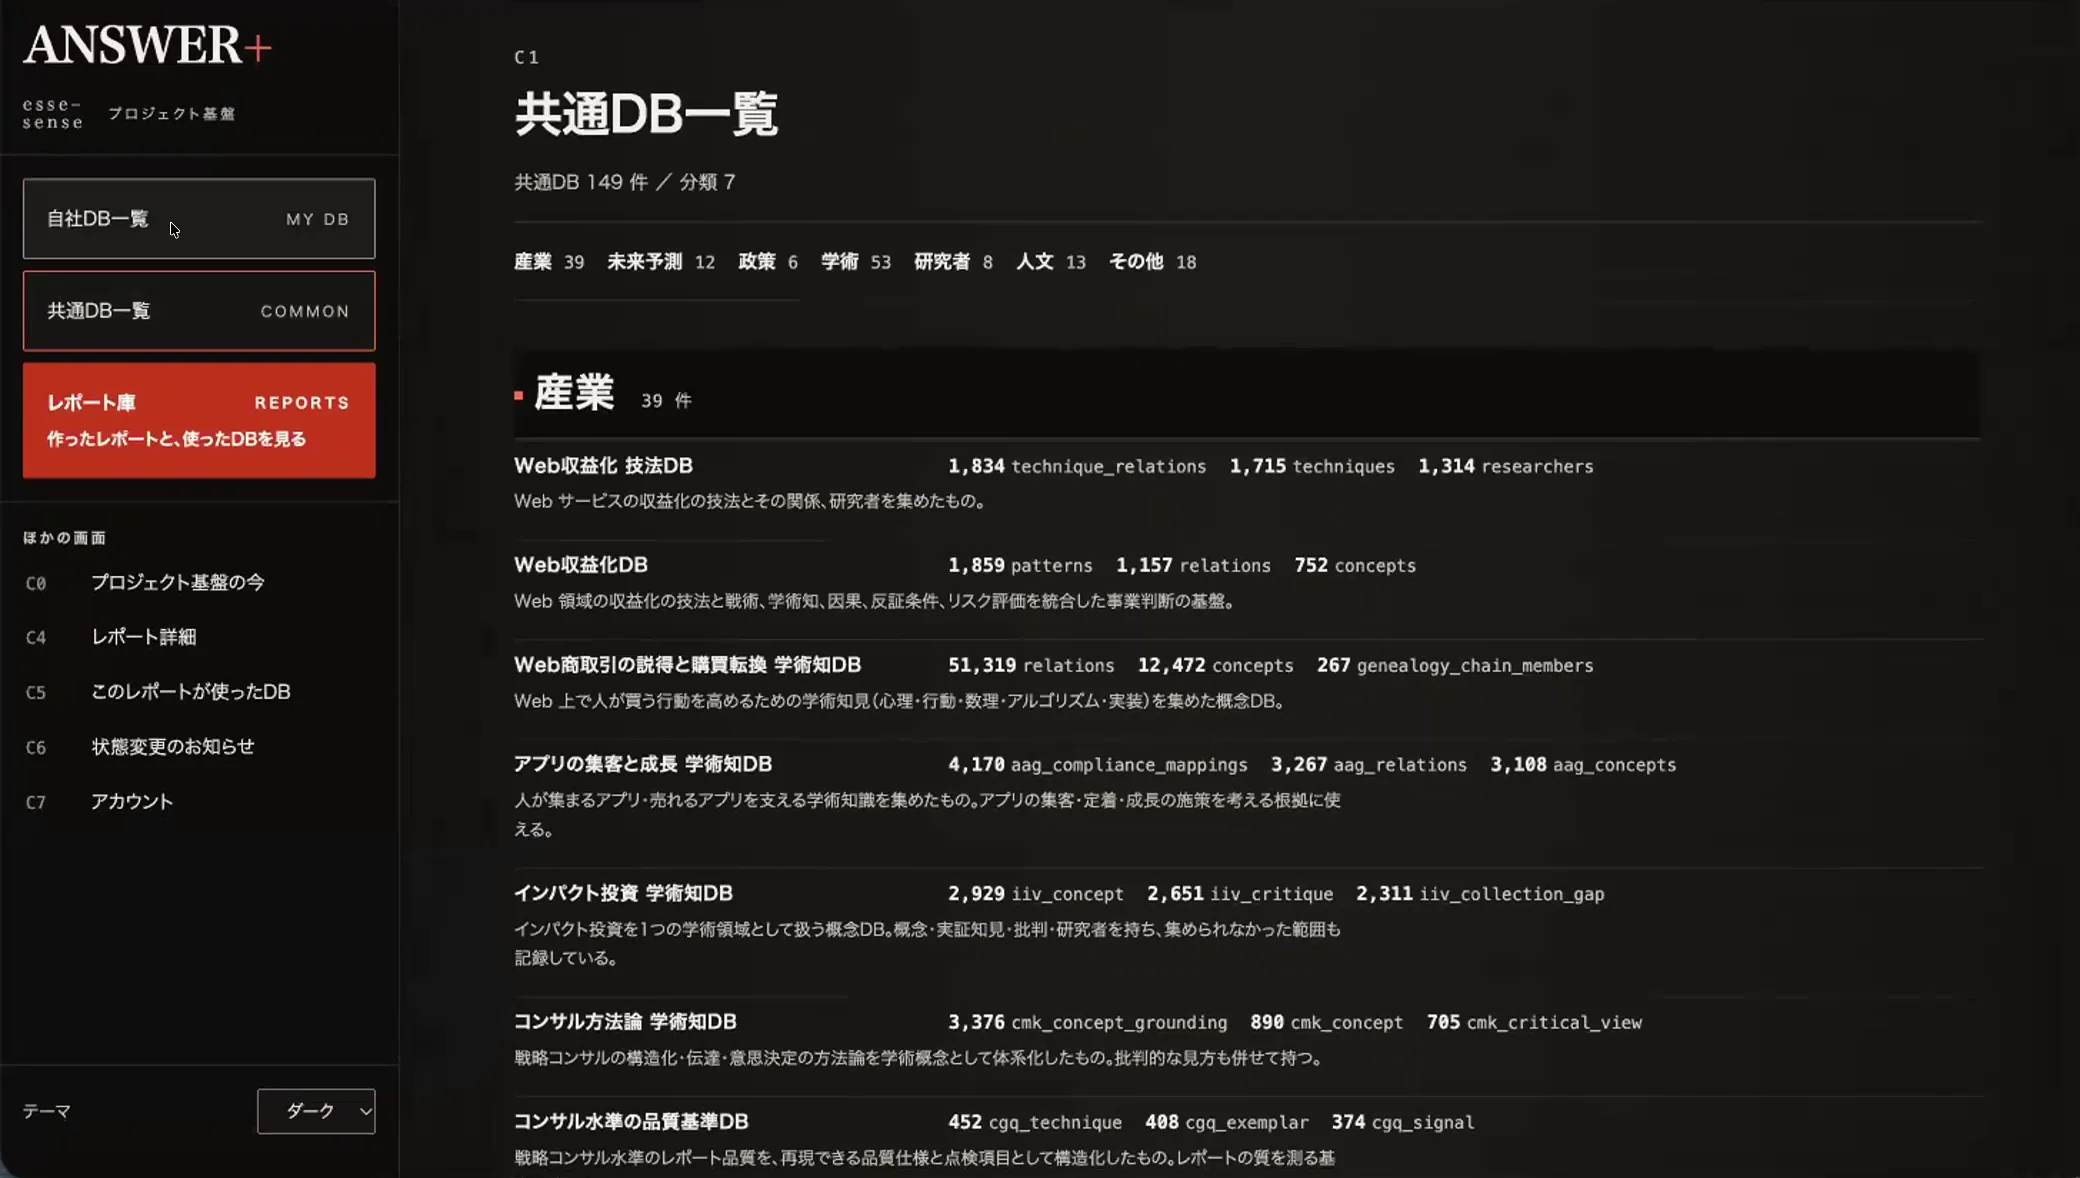
引いてくる先に何もなければ答えは出ない。そのためにANSWER+のもとには292のデータベースがあり、4億3000万レコードを持つと西村は述べた。研究者や論文のほか、文化、投資の動き、上場企業のIR、プレスリリース、未来洞察、政策の情報が入っている。量の基準は「理論的飽和」の考え方で、ある回答に十分な情報量があれば、100でなく99でも答えられる。西村が15年ほど続けてきたこの方法を自動化し、仕組みにしているという。1つのデータベースを徹底的に大きくするのではなく、観点ごとに複数のデータベースが補い合う形にし、半年かけて7600億トークンの計算を行ったと紹介した。工程の段階ごとにハルシネーションを防ぐ仕組みを入れているとも述べた。
「ある回答を取るために十分な情報量。それは別に100じゃなくて99でもいいわけです。」 ― 映像 29:09 の発言
まとめ
組織の外にある知識で、確かな判断の基盤をつくる
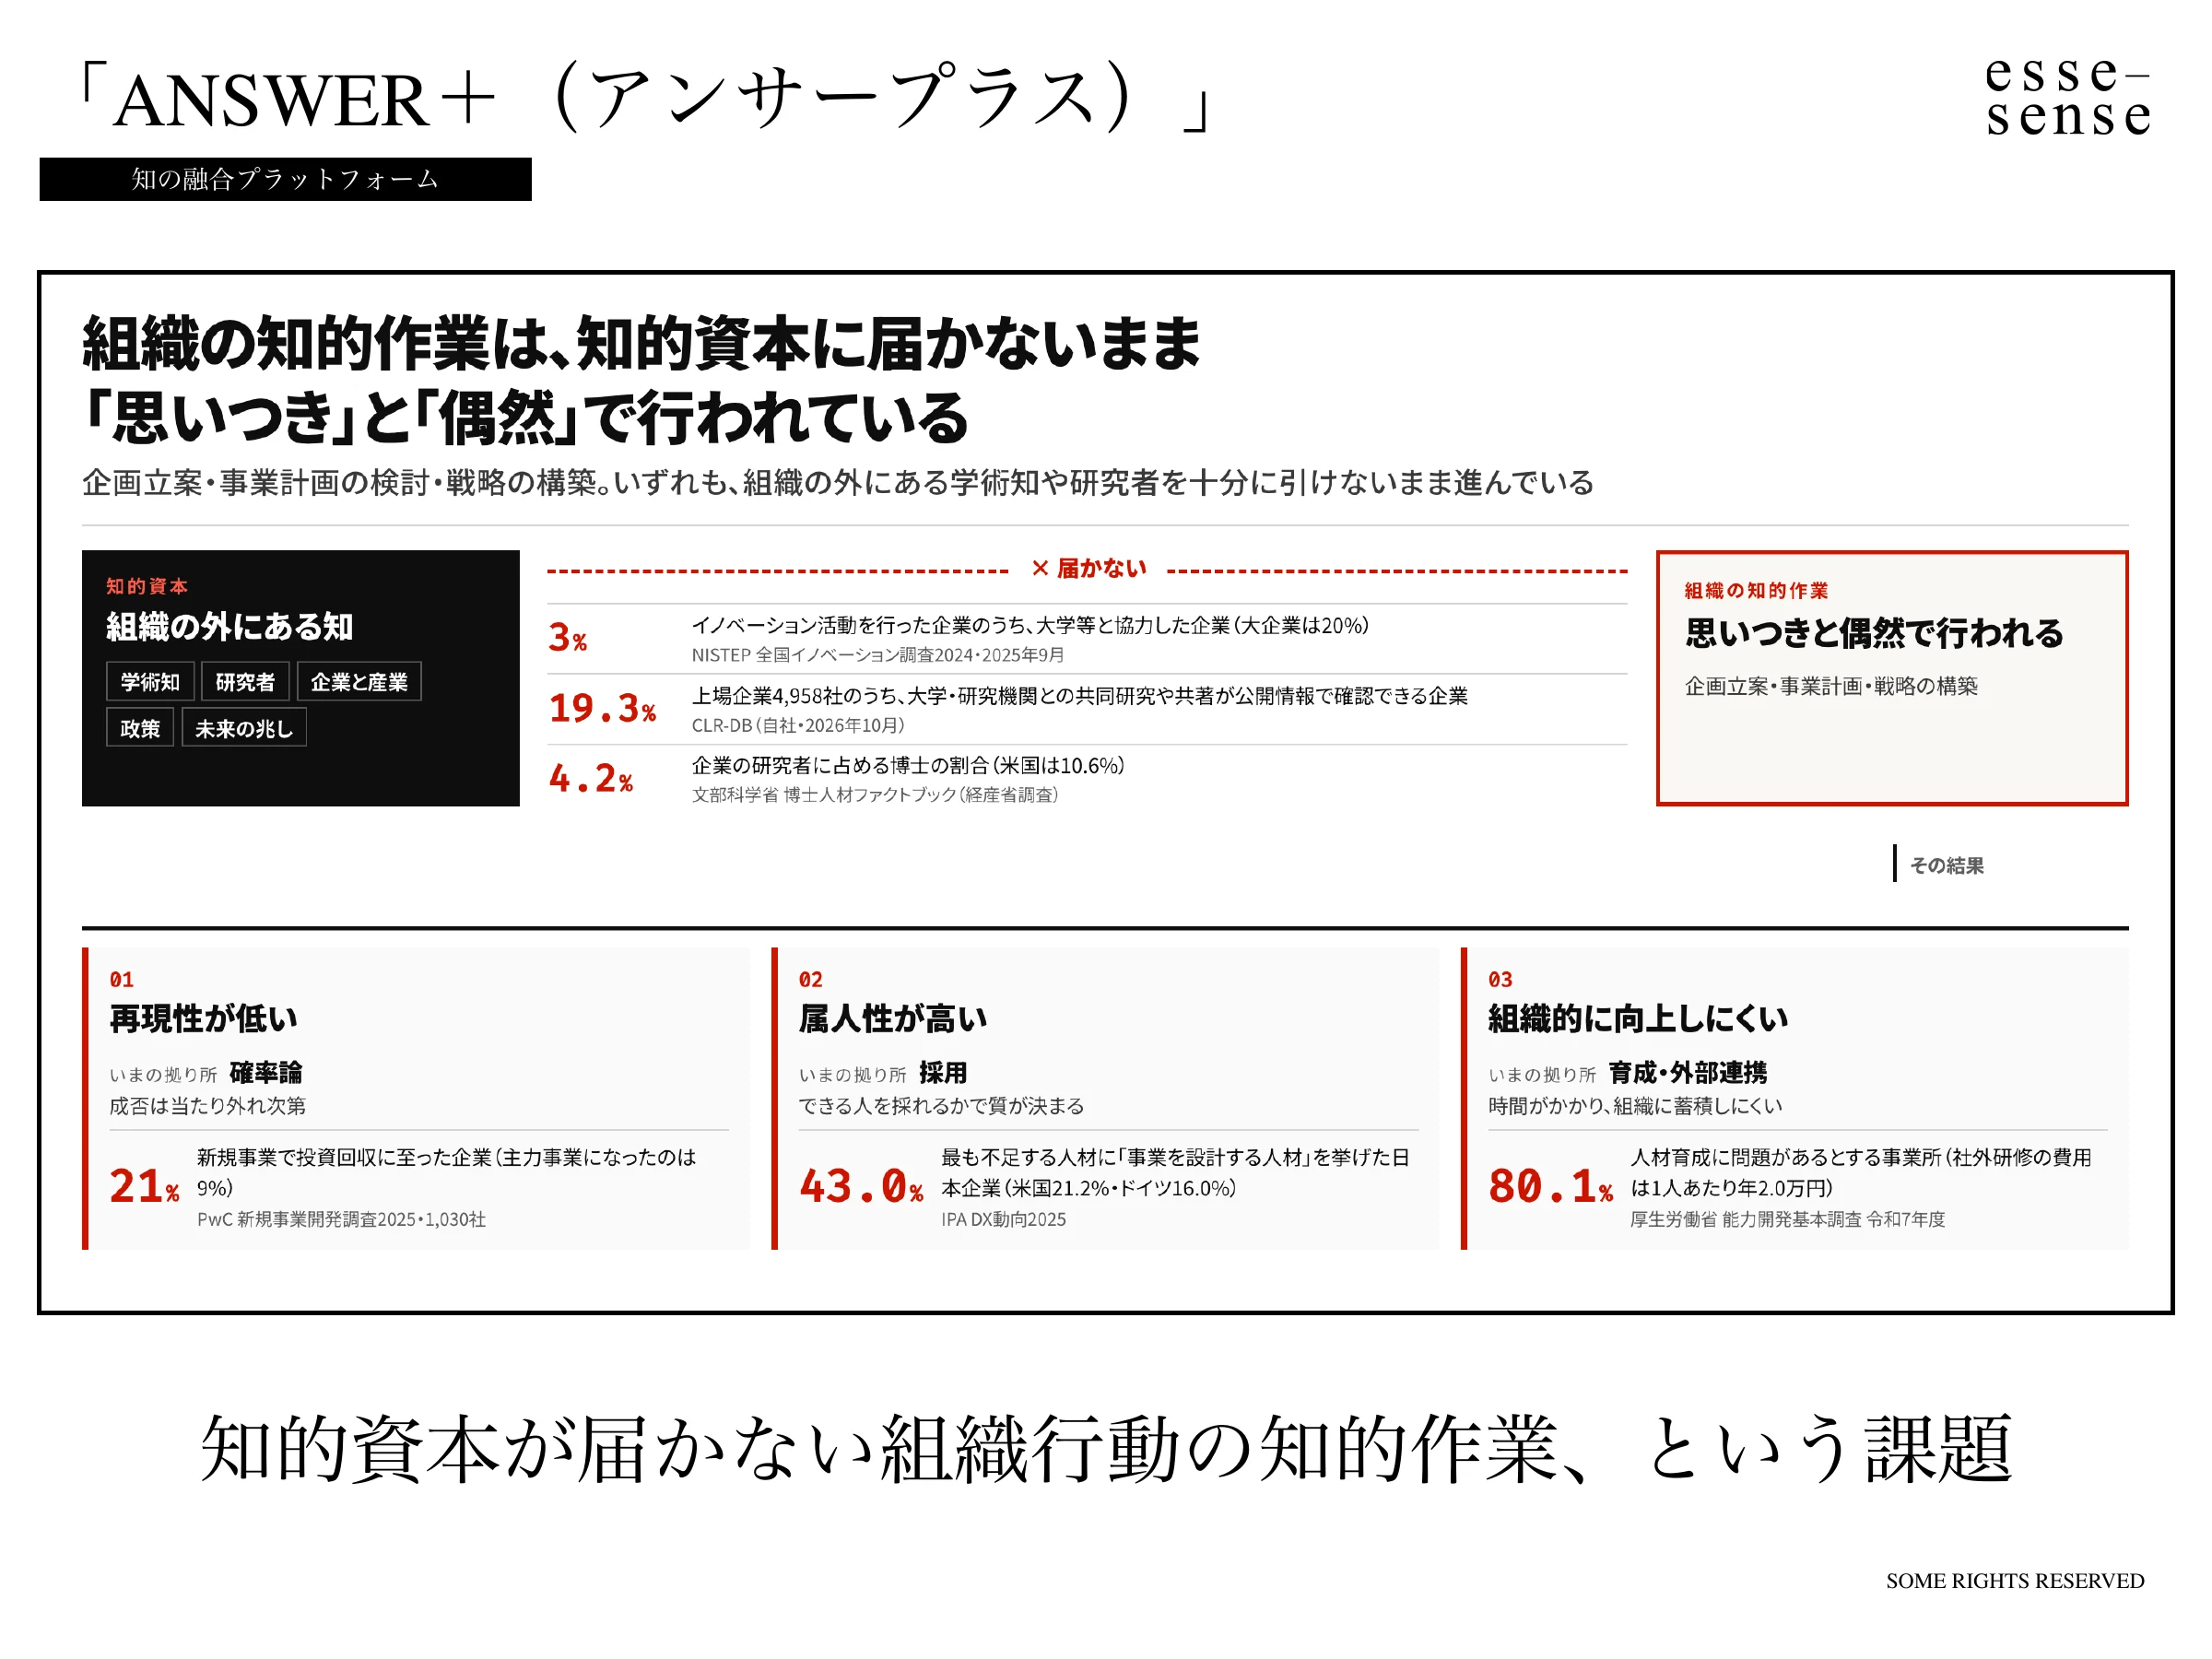
西村は、esse-senseを2021年に、国内に34万人いる研究者の知的資本が産業の中であまり使われていないことを解消するために立ち上げたと述べた。ANSWER+で行っていることもそれと変わらず、学術、産業、政策、未来の兆しといった組織の外にある知識を使うことで、思いつきや偶然でなく、確かな知見に基づいた組織行動を作っていくことだという。生成AIに書かせるのではなく記録を引かせ、人が考えて判断するための支えにする。説明会で語られた問題意識は、この一点に集まっていた。
「確かな知見に基づいた基盤のある組織行動を作っていく」 ― 映像 32:10 の発言
概要
2026年10月19日にオンラインで開かれた「第1回 ANSWER+説明会」の記録。esse-sense 共創推進チームの三浦英雄が進行し、代表の西村勇也が、生成AIに直接答えさせない理由、産業革命との対比で見た「確かめる負荷」、292のデータベースから記録を引いてから書くという仕組みを説明した。孤独をテーマにした実演、追加解析やプロジェクト専用データベースなど次のリリースの見通し、トライアルと料金の案内までを約56分で収めている。
冒頭で三浦は、9月1日にリリースされたANSWER+を、企業の未来洞察や未来戦略策定において情報収集と意思決定を支援する仕組みと紹介した。西村は esse-sense を、国内34万人の研究者が持つ知的資本と産業の分断を解消するために2021年に立ち上げた会社だと説明し、創業時から続けてきた属人的な方法論ではなくシステムとして知的資本を産業につなげる取り組みの積み上げの上にANSWER+があると位置づけた。
西村は、生成AIに直接問いかける課題として、AIを入れただけでは成果が出ないこと、使ったことを隠して結果を確かめずに使う人が多いこと、ハルシネーションの3点を挙げた。生成AIはもともと回答するための仕組みではないため、ハルシネーションは構造的な問題で解消しないと述べ、AIの誤りによる司法的な問題が2025年の87件から2026年10月には2200件近くまで増えたと紹介した。さらに産業革命の機織りの自動化で自動化できない部分に負荷が集中したのと同じように、AIに書かせると「確かめる・直す・資料に当たる」労働が末端にかかると説明した。
esse-sense の答えは、AIの役割を「書く」から「記録を引く」へ切り替えることだと西村は述べた。西村によれば、ANSWER+は問いを受けると、事前に準備した292のデータベース(4億3000万レコード)から素材を引き、構成して文章にし、文献の実在を検証して根拠をたどれる回答を作る。データベースの量は「理論的飽和」という十分さの考え方で決め、複数が補い合う形にしたと説明した。デモでは「孤独」をテーマに、素材集め、構成、文章化の流れを示した。
次のリリースについては、レポートに問いかけてまとめ直す追加解析が来月ぐらいにはリリースできそうだと述べ、企業ごとのプロジェクト専用データベースを共通データベースと組み合わせる仕組みは年内を目指して開発中だと語った。最後に三浦が、1ヶ月3名分50万円のトライアル、月々80万円のベーシック、内部データと結合するエンタープライズを案内し、トライアルはオンボーディングセッションで利用目的を設定してから始めると説明した。
数値はいずれも講演での発言による。スライドではデータベースを「250超」「400超・約4.17億レコード」と表記しており、提供中の版については講演で「200ほどのデータベース群」とも述べている。
構成
開会と本日の流れ
三浦が開会し、9月1日にリリースされたANSWER+を、学術知と産業側のデータベースを組み合わせて未来戦略の策定を支える仕組みとして紹介した。会社紹介、開発の背景と特徴、デモ、費用とトライアル、質疑応答の順に進めると案内し、西村が問題意識から話すと述べて始まった。
esse-sense が目指していること ― 知的資本と産業のあいだ
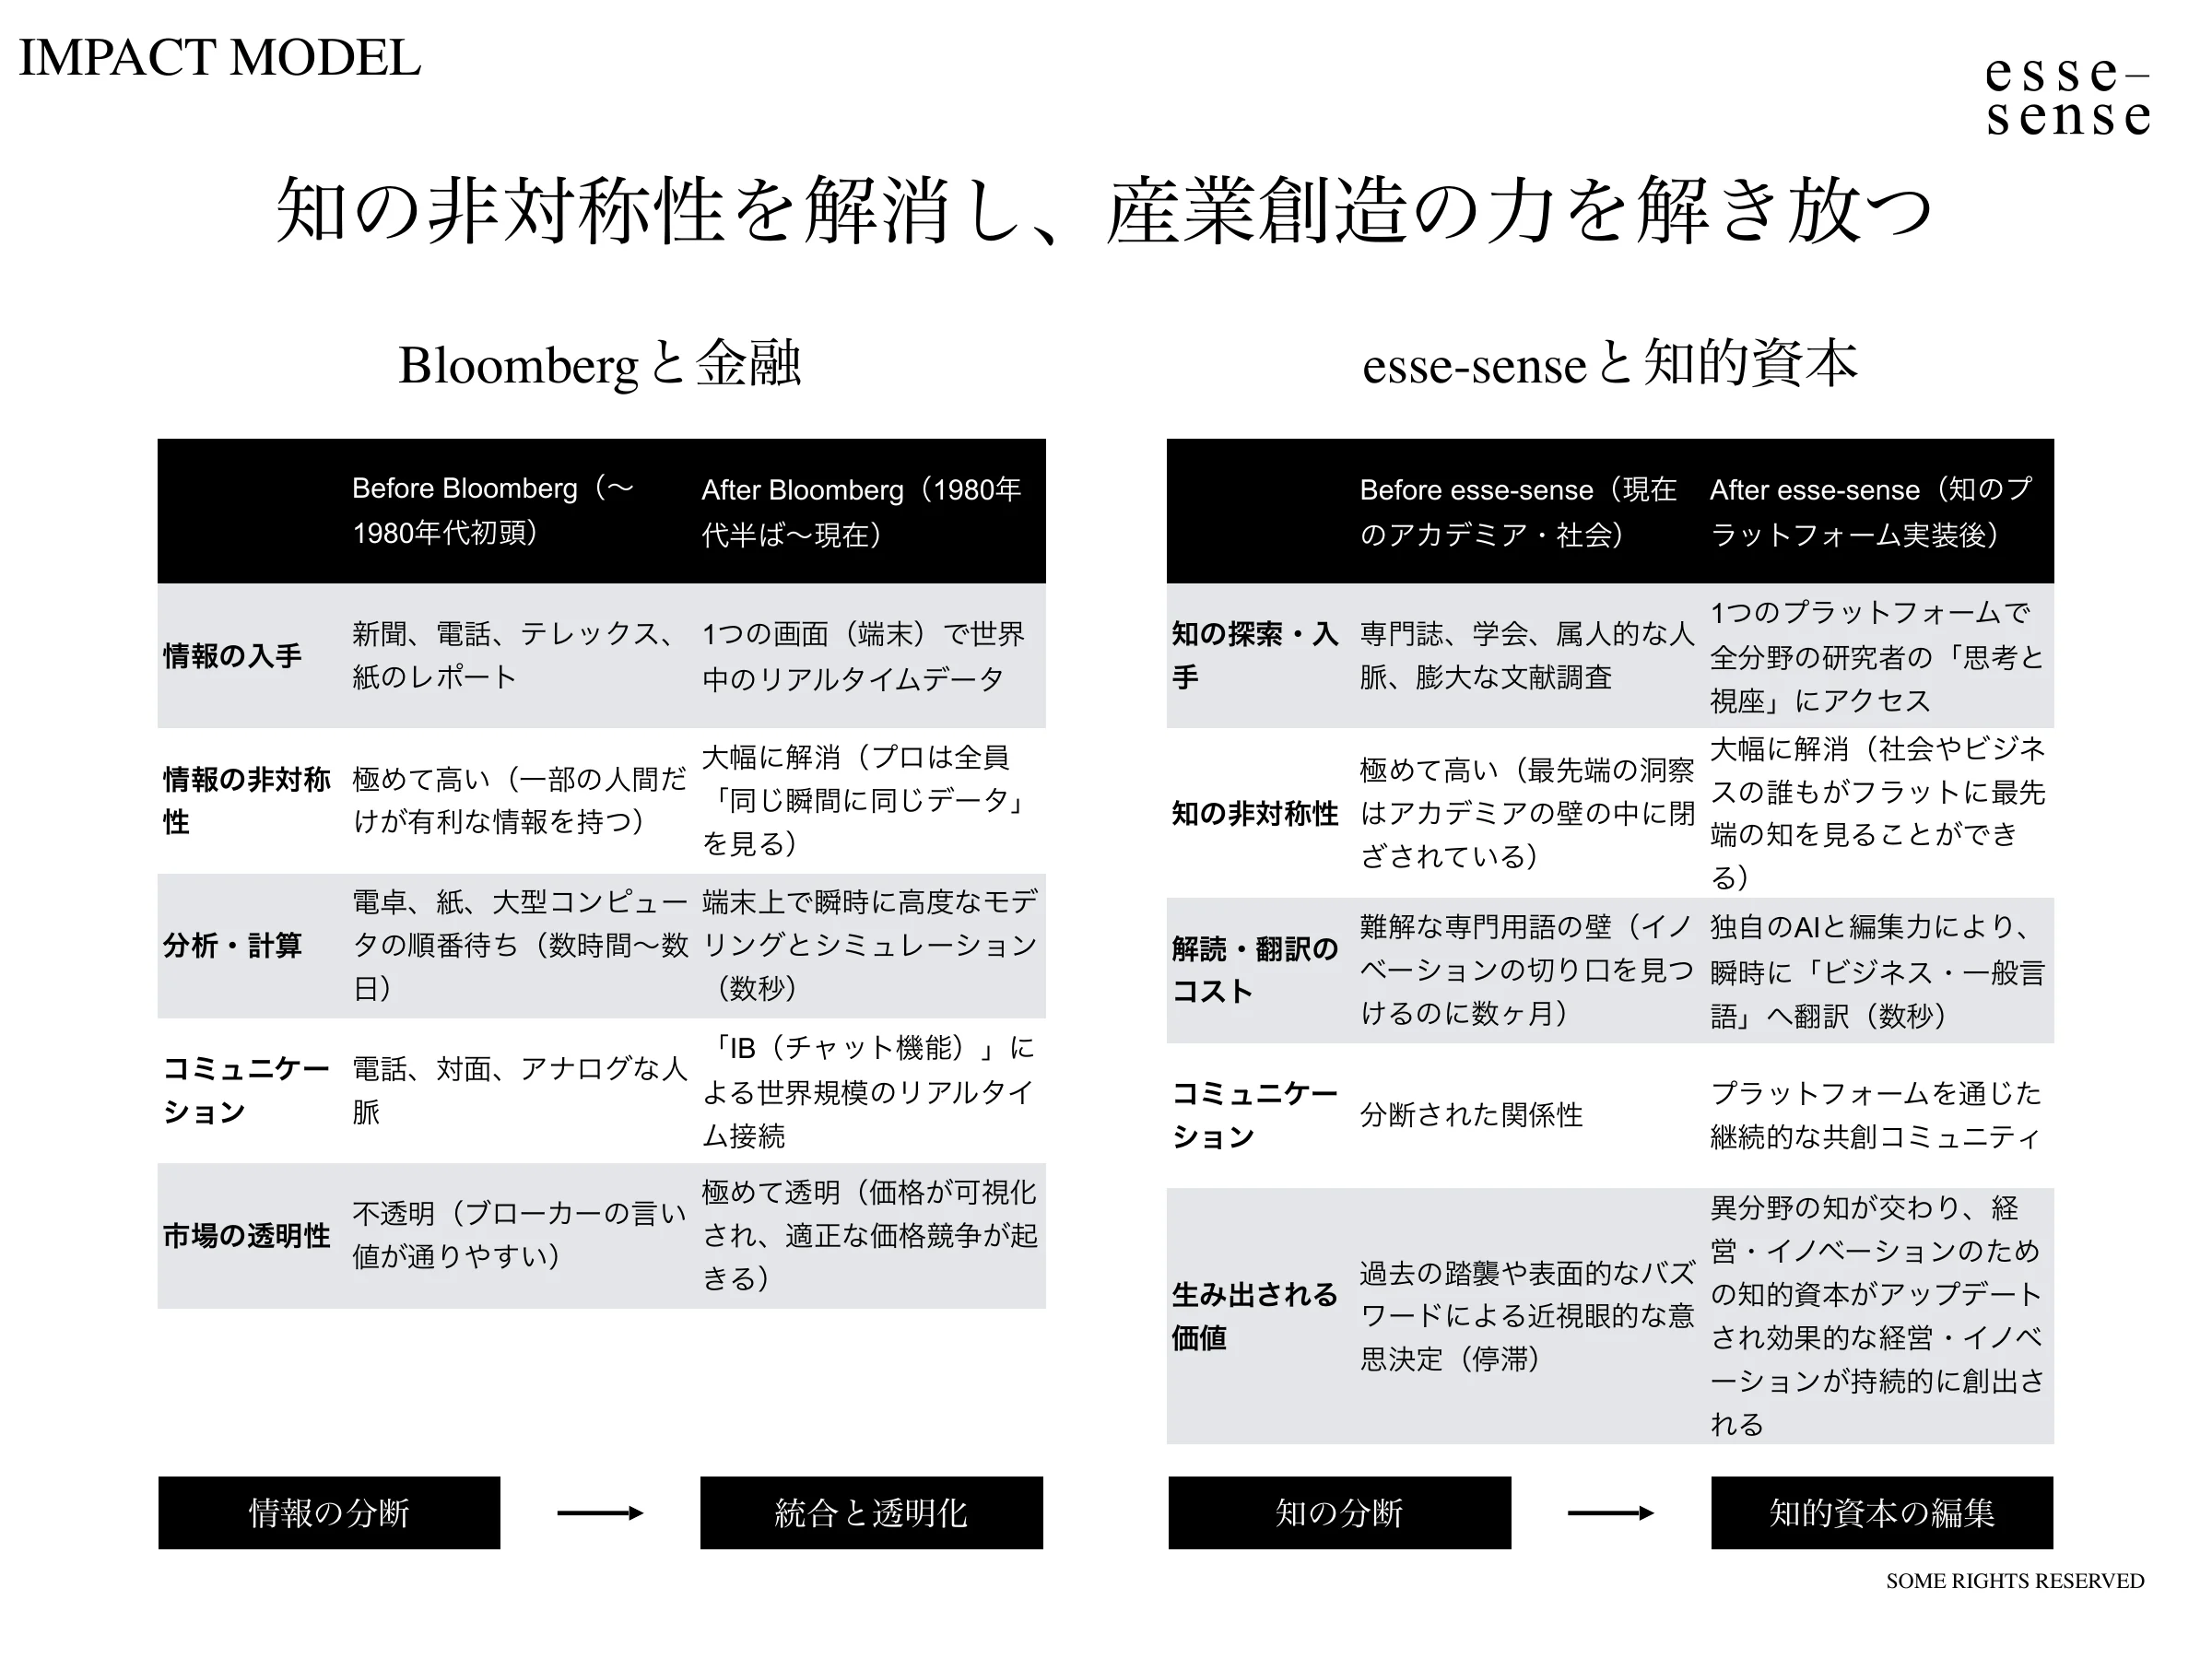
西村は esse-sense を、国内34万人の研究者が持つ知的資本と産業の分断を解消するために2021年に立ち上げた会社だと説明した。学術界と産業界の間に立つ Translational Edit で知を解体・編集・再構築し、ブルームバーグが金融情報の非対称性を変えたように知的資本のブラックボックスを変えていくと述べた。
ANSWER+に至るまで ― 2021年からの積み上げ
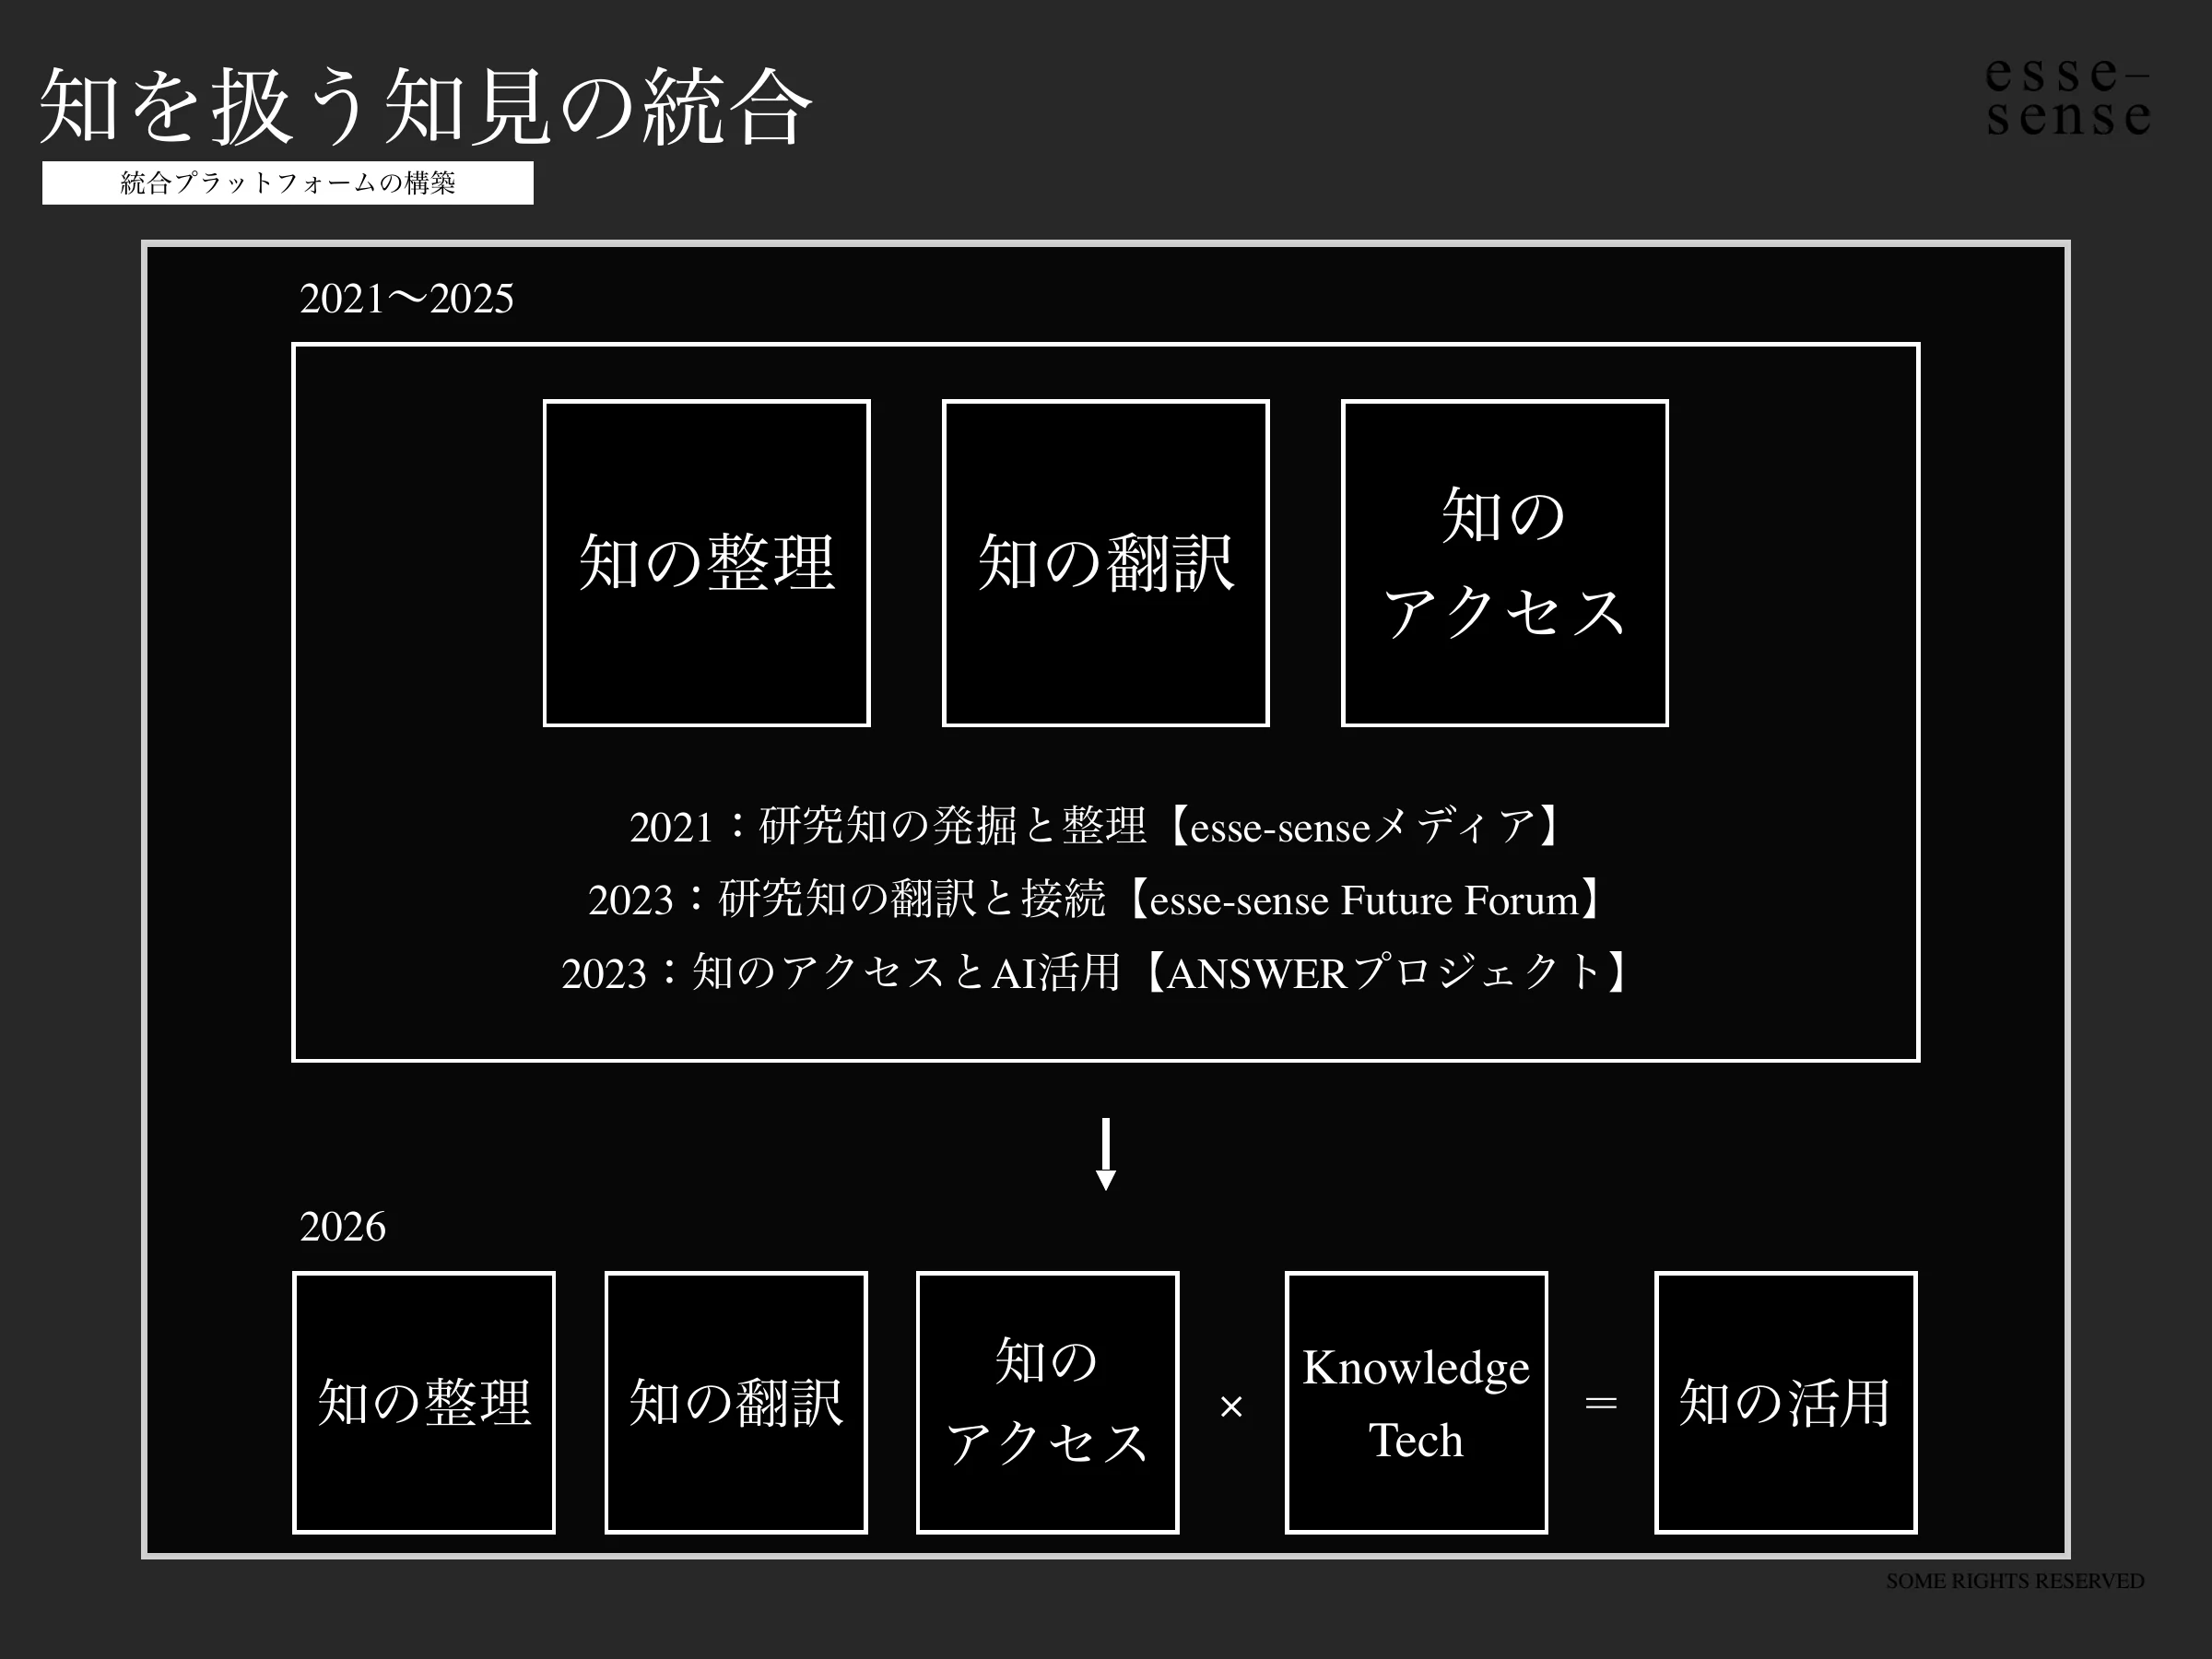
2023年から取り組むANSWERプロジェクトは突然出てきたものではなく、2021年のメディア立ち上げ以来の研究知の発掘整理や翻訳と接続の積み上げの上にあると西村は述べた。知の整理・翻訳・アクセスにテクノロジーを組み合わせ、AIに答えさせるのではなく、背景のデータベース構築に力を入れていると説明した。
なぜ生成AIに直接答えさせないのか
AIを入れても100社のうち95社では成果が出ていないという調査(出典は講演で示されていない)、結果を確かめず隠して使う傾向、そしてハルシネーションの3点を西村は挙げた。生成AIは回答する仕組みでなく、ハルシネーションは構造上の問題で解消しないと述べ、AIの誤りによる司法的な問題が87件から2200件近くへ増えた例を紹介した。
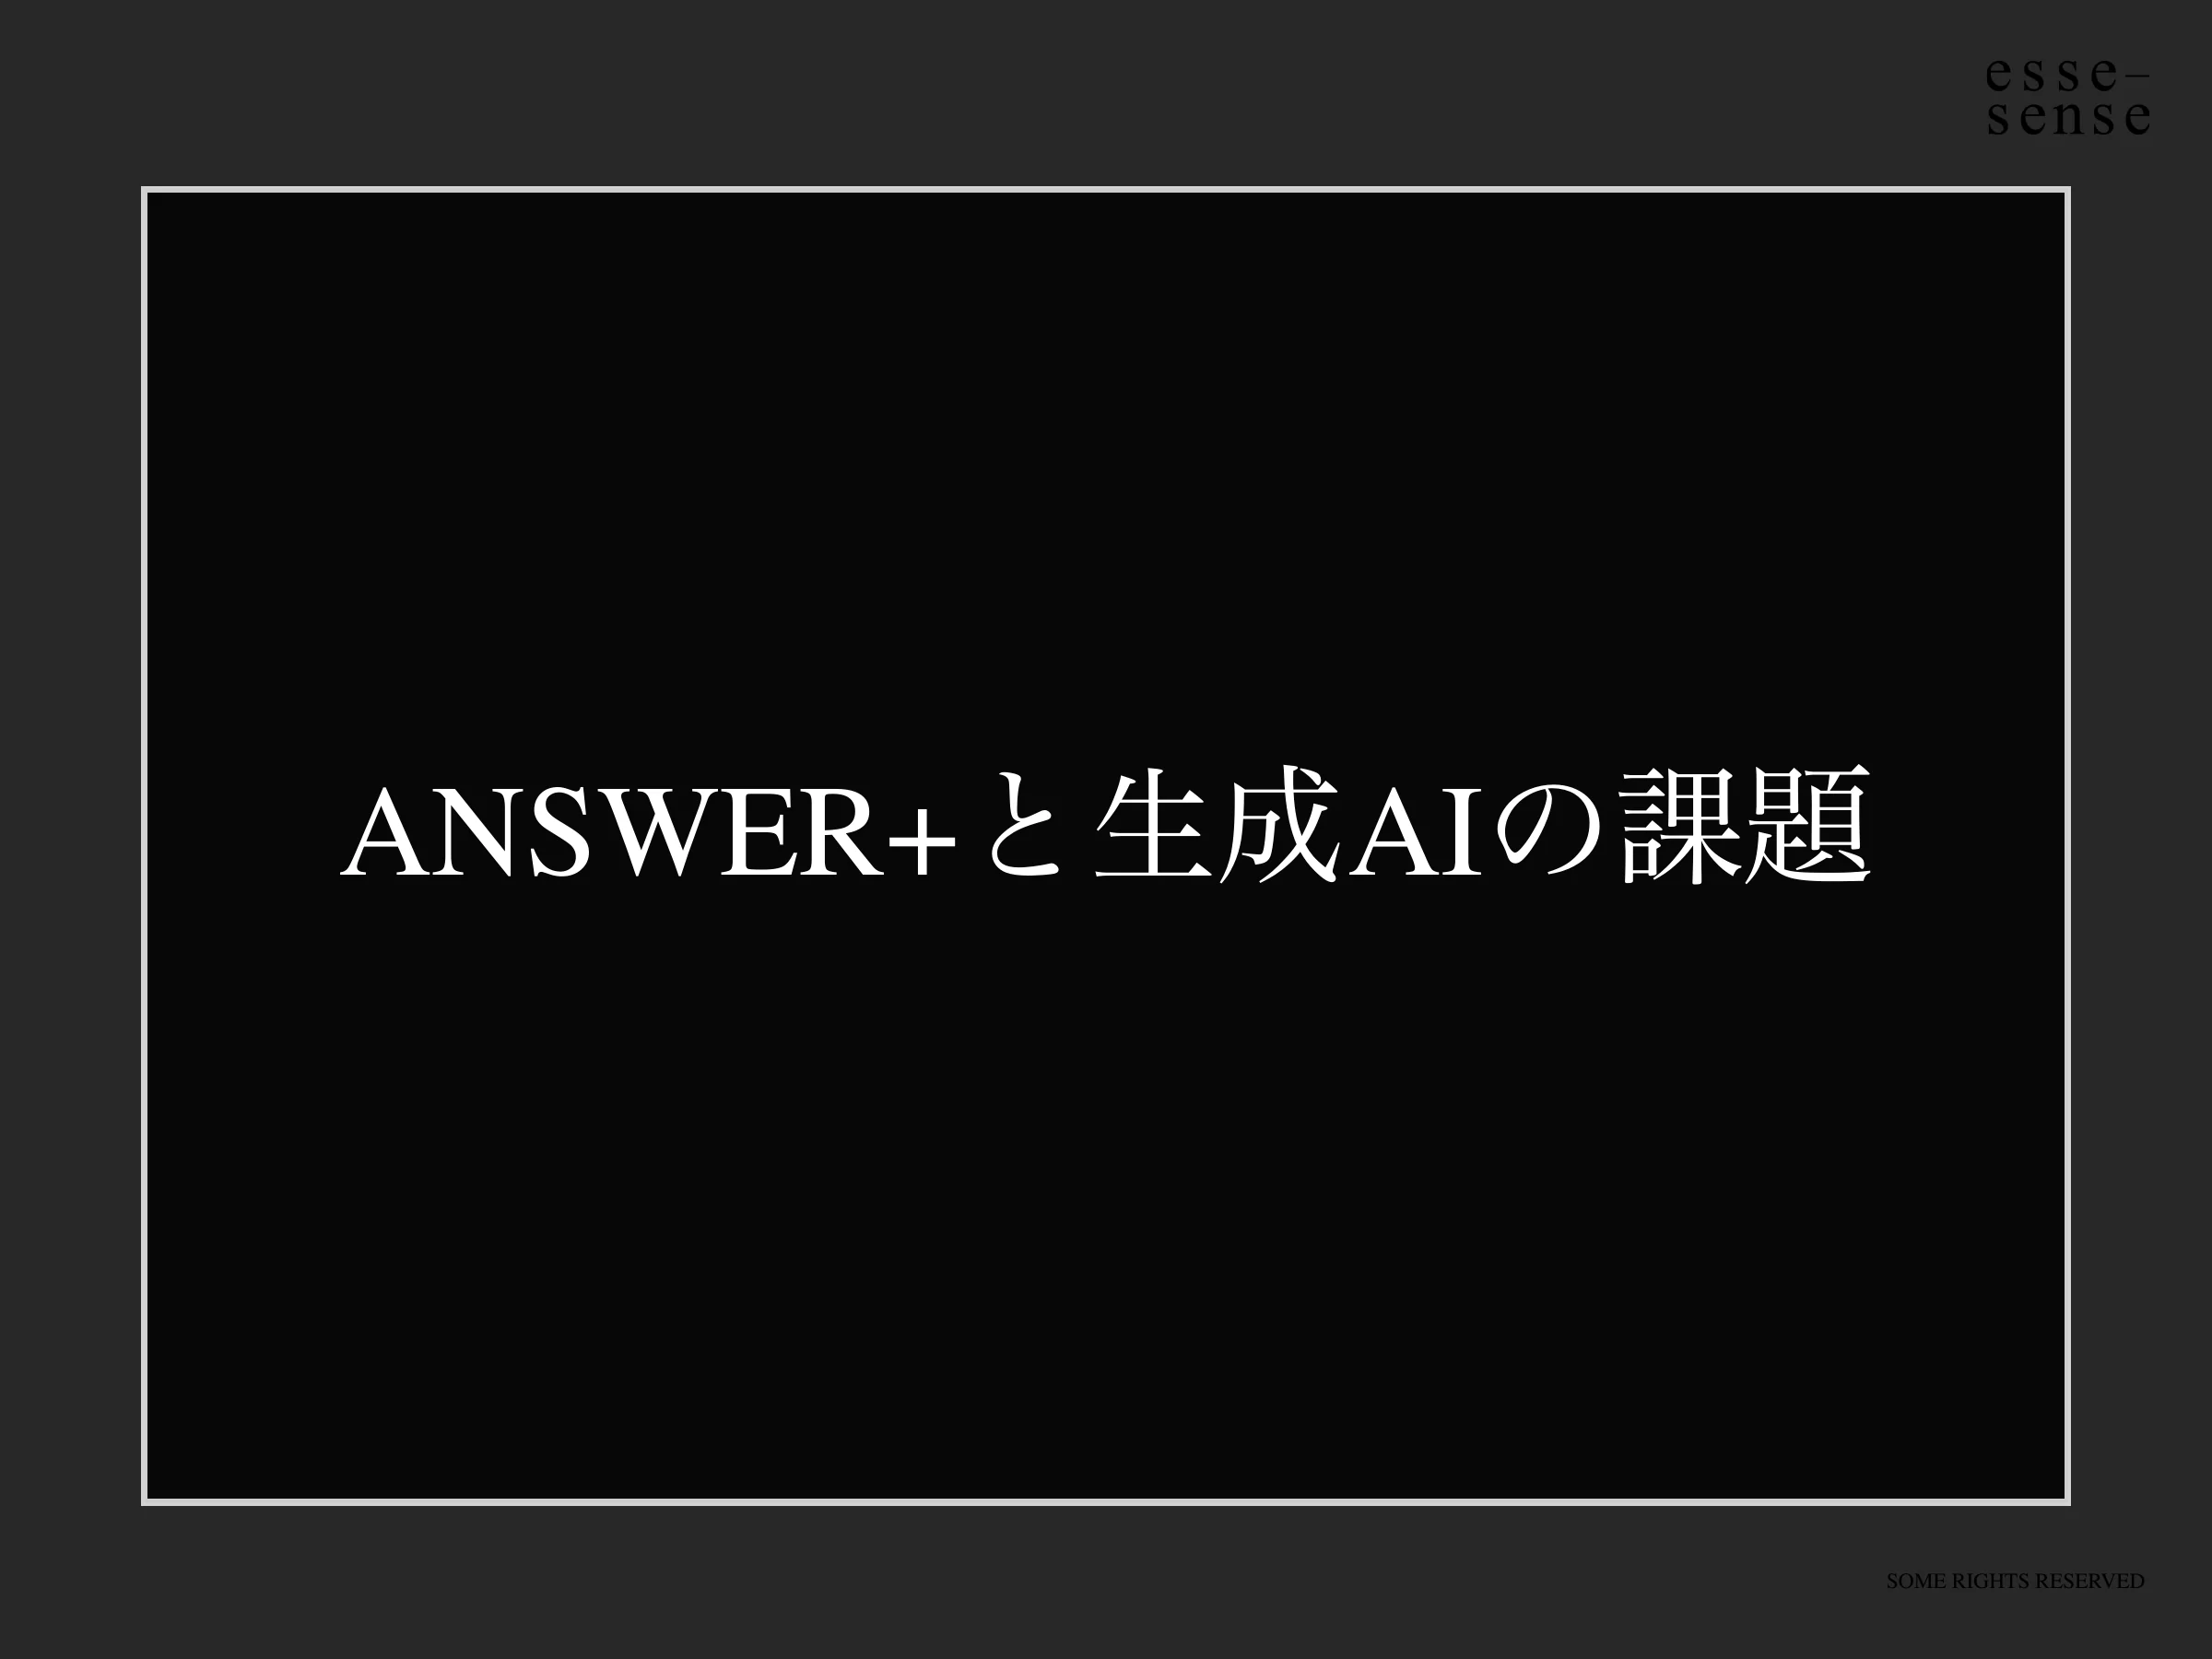
産業革命から読むAI革命 ― 負荷は末端にかかる
産業革命の機織りの自動化で、自動化できない部分に負荷が爆増したことを引き、AIでも確かめる・直す・資料に当たる労働が末端に増えると西村は述べた。この主従を逆転させ、先に確かめて資料を紐づけたものを作る、つまりAIに記録を引かせるのがANSWER+の考え方だと説明した。
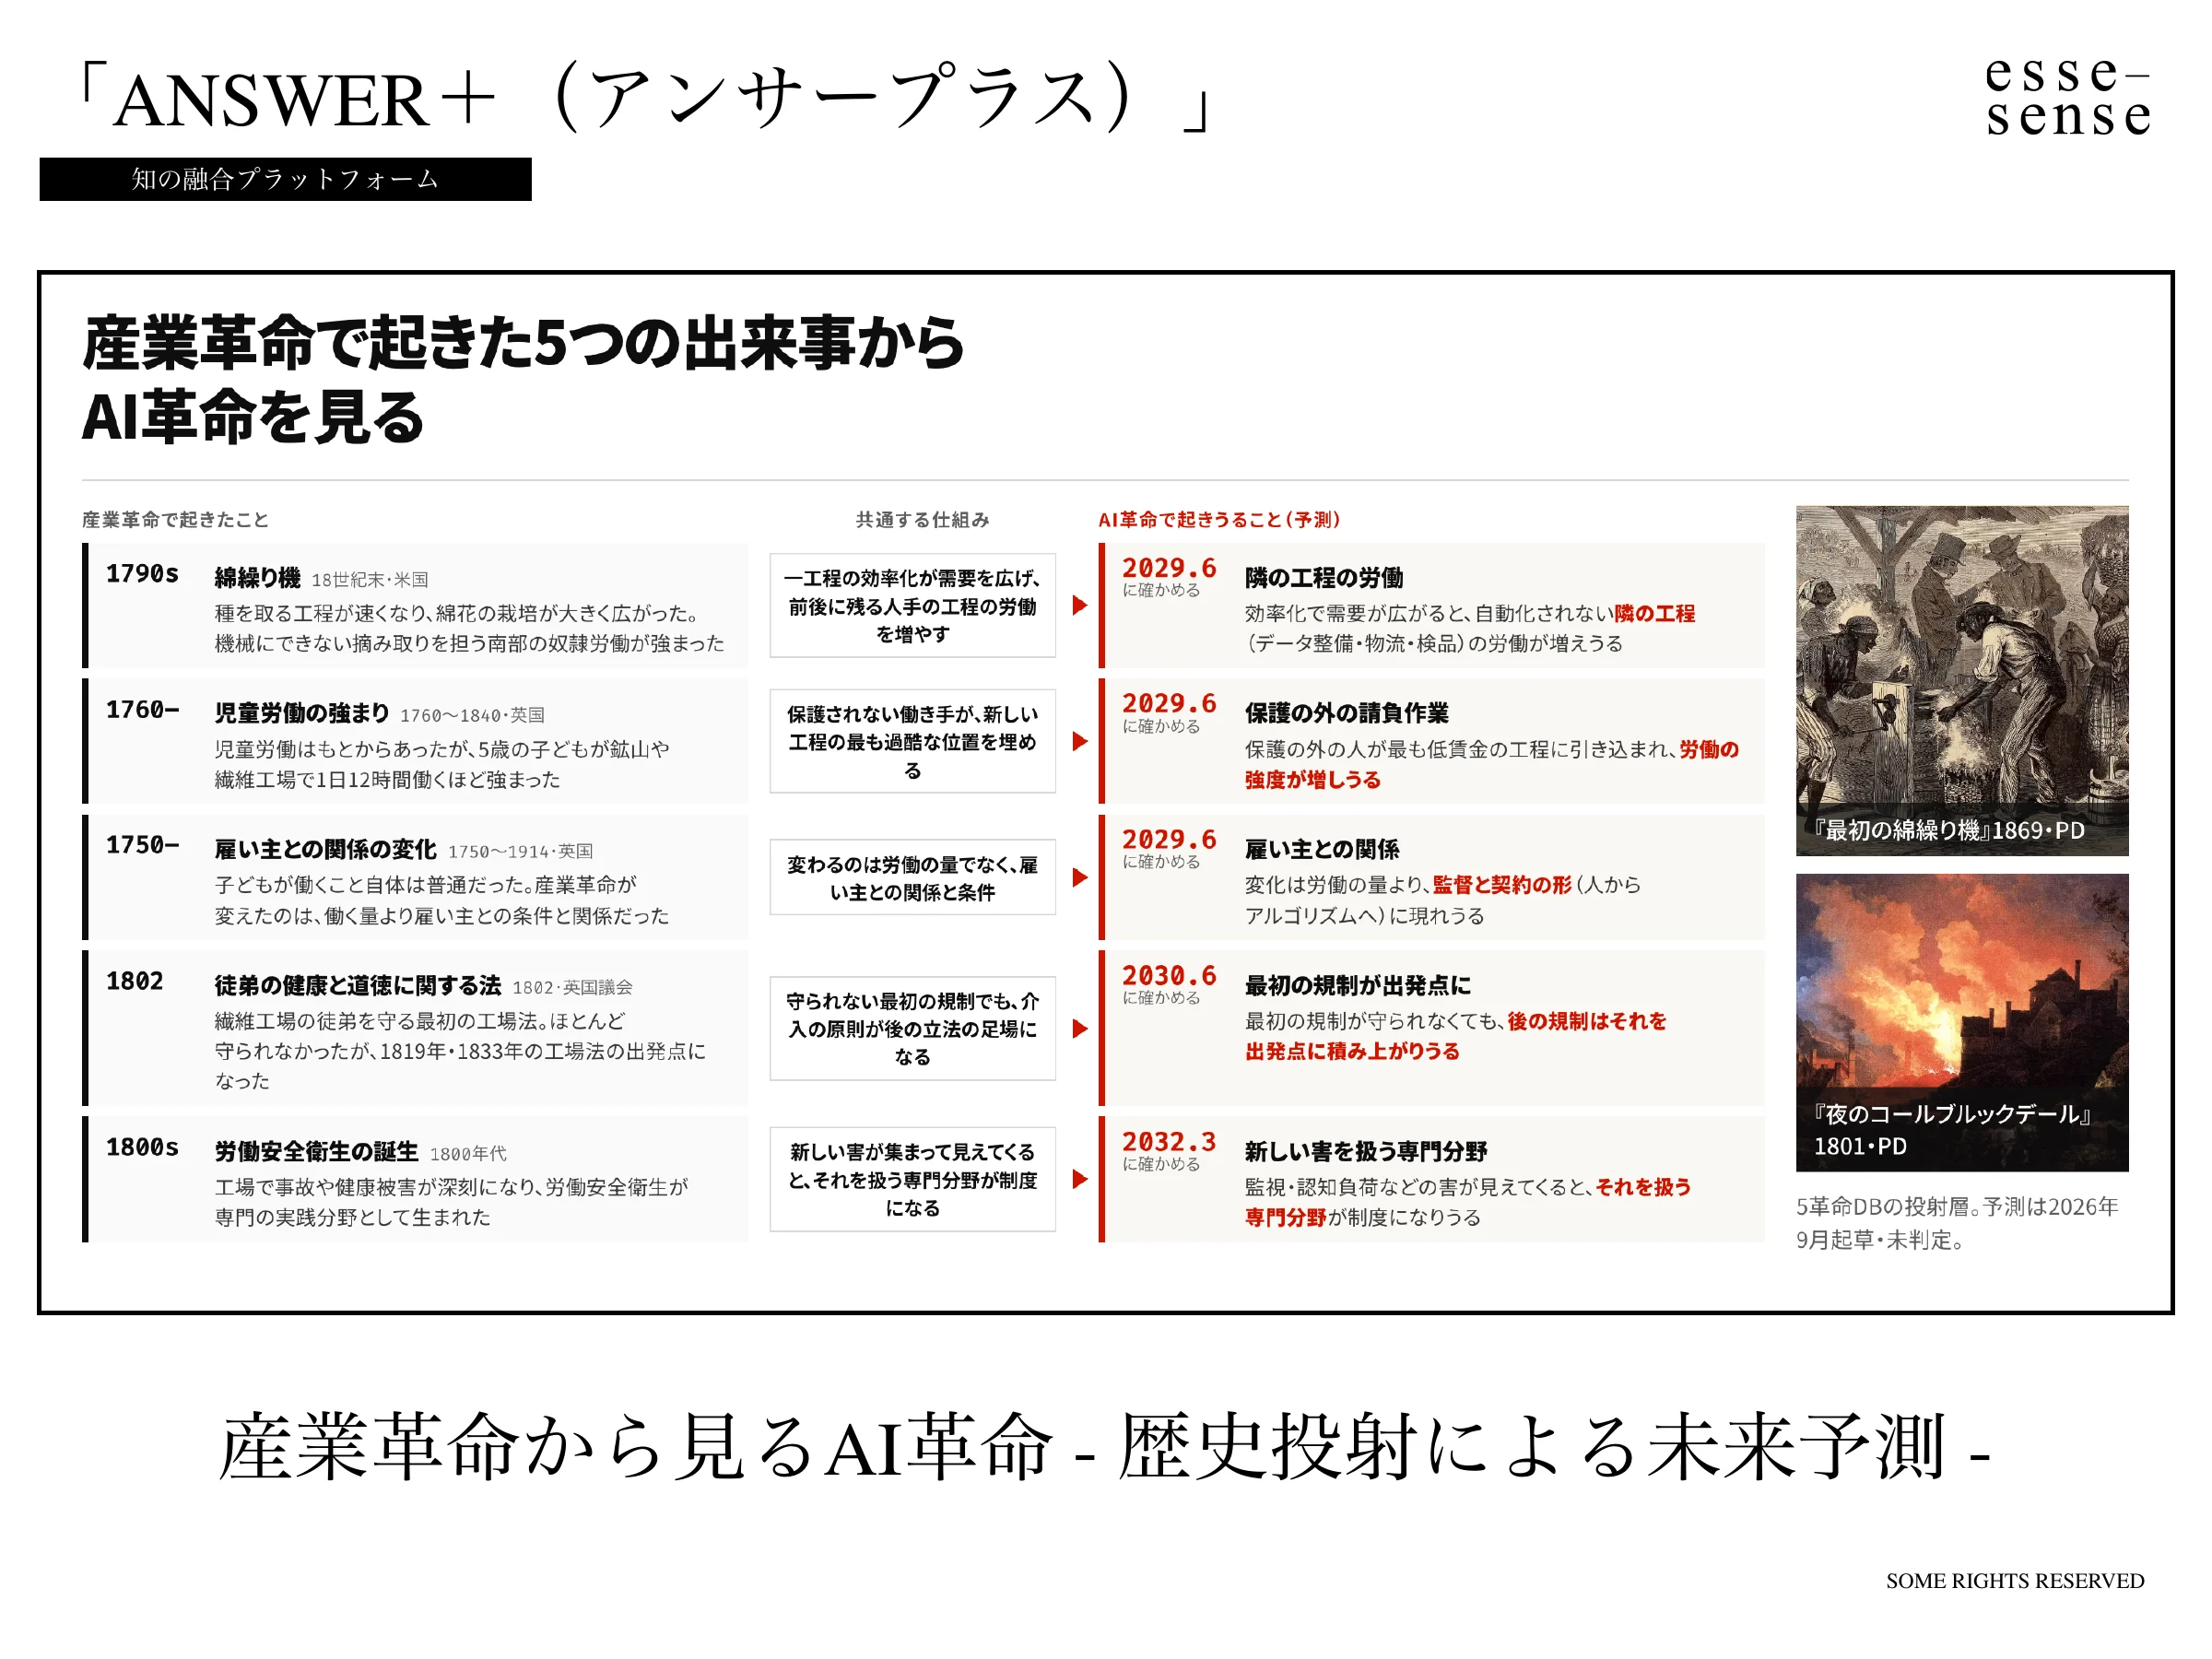
esse-sense の開発の歴史
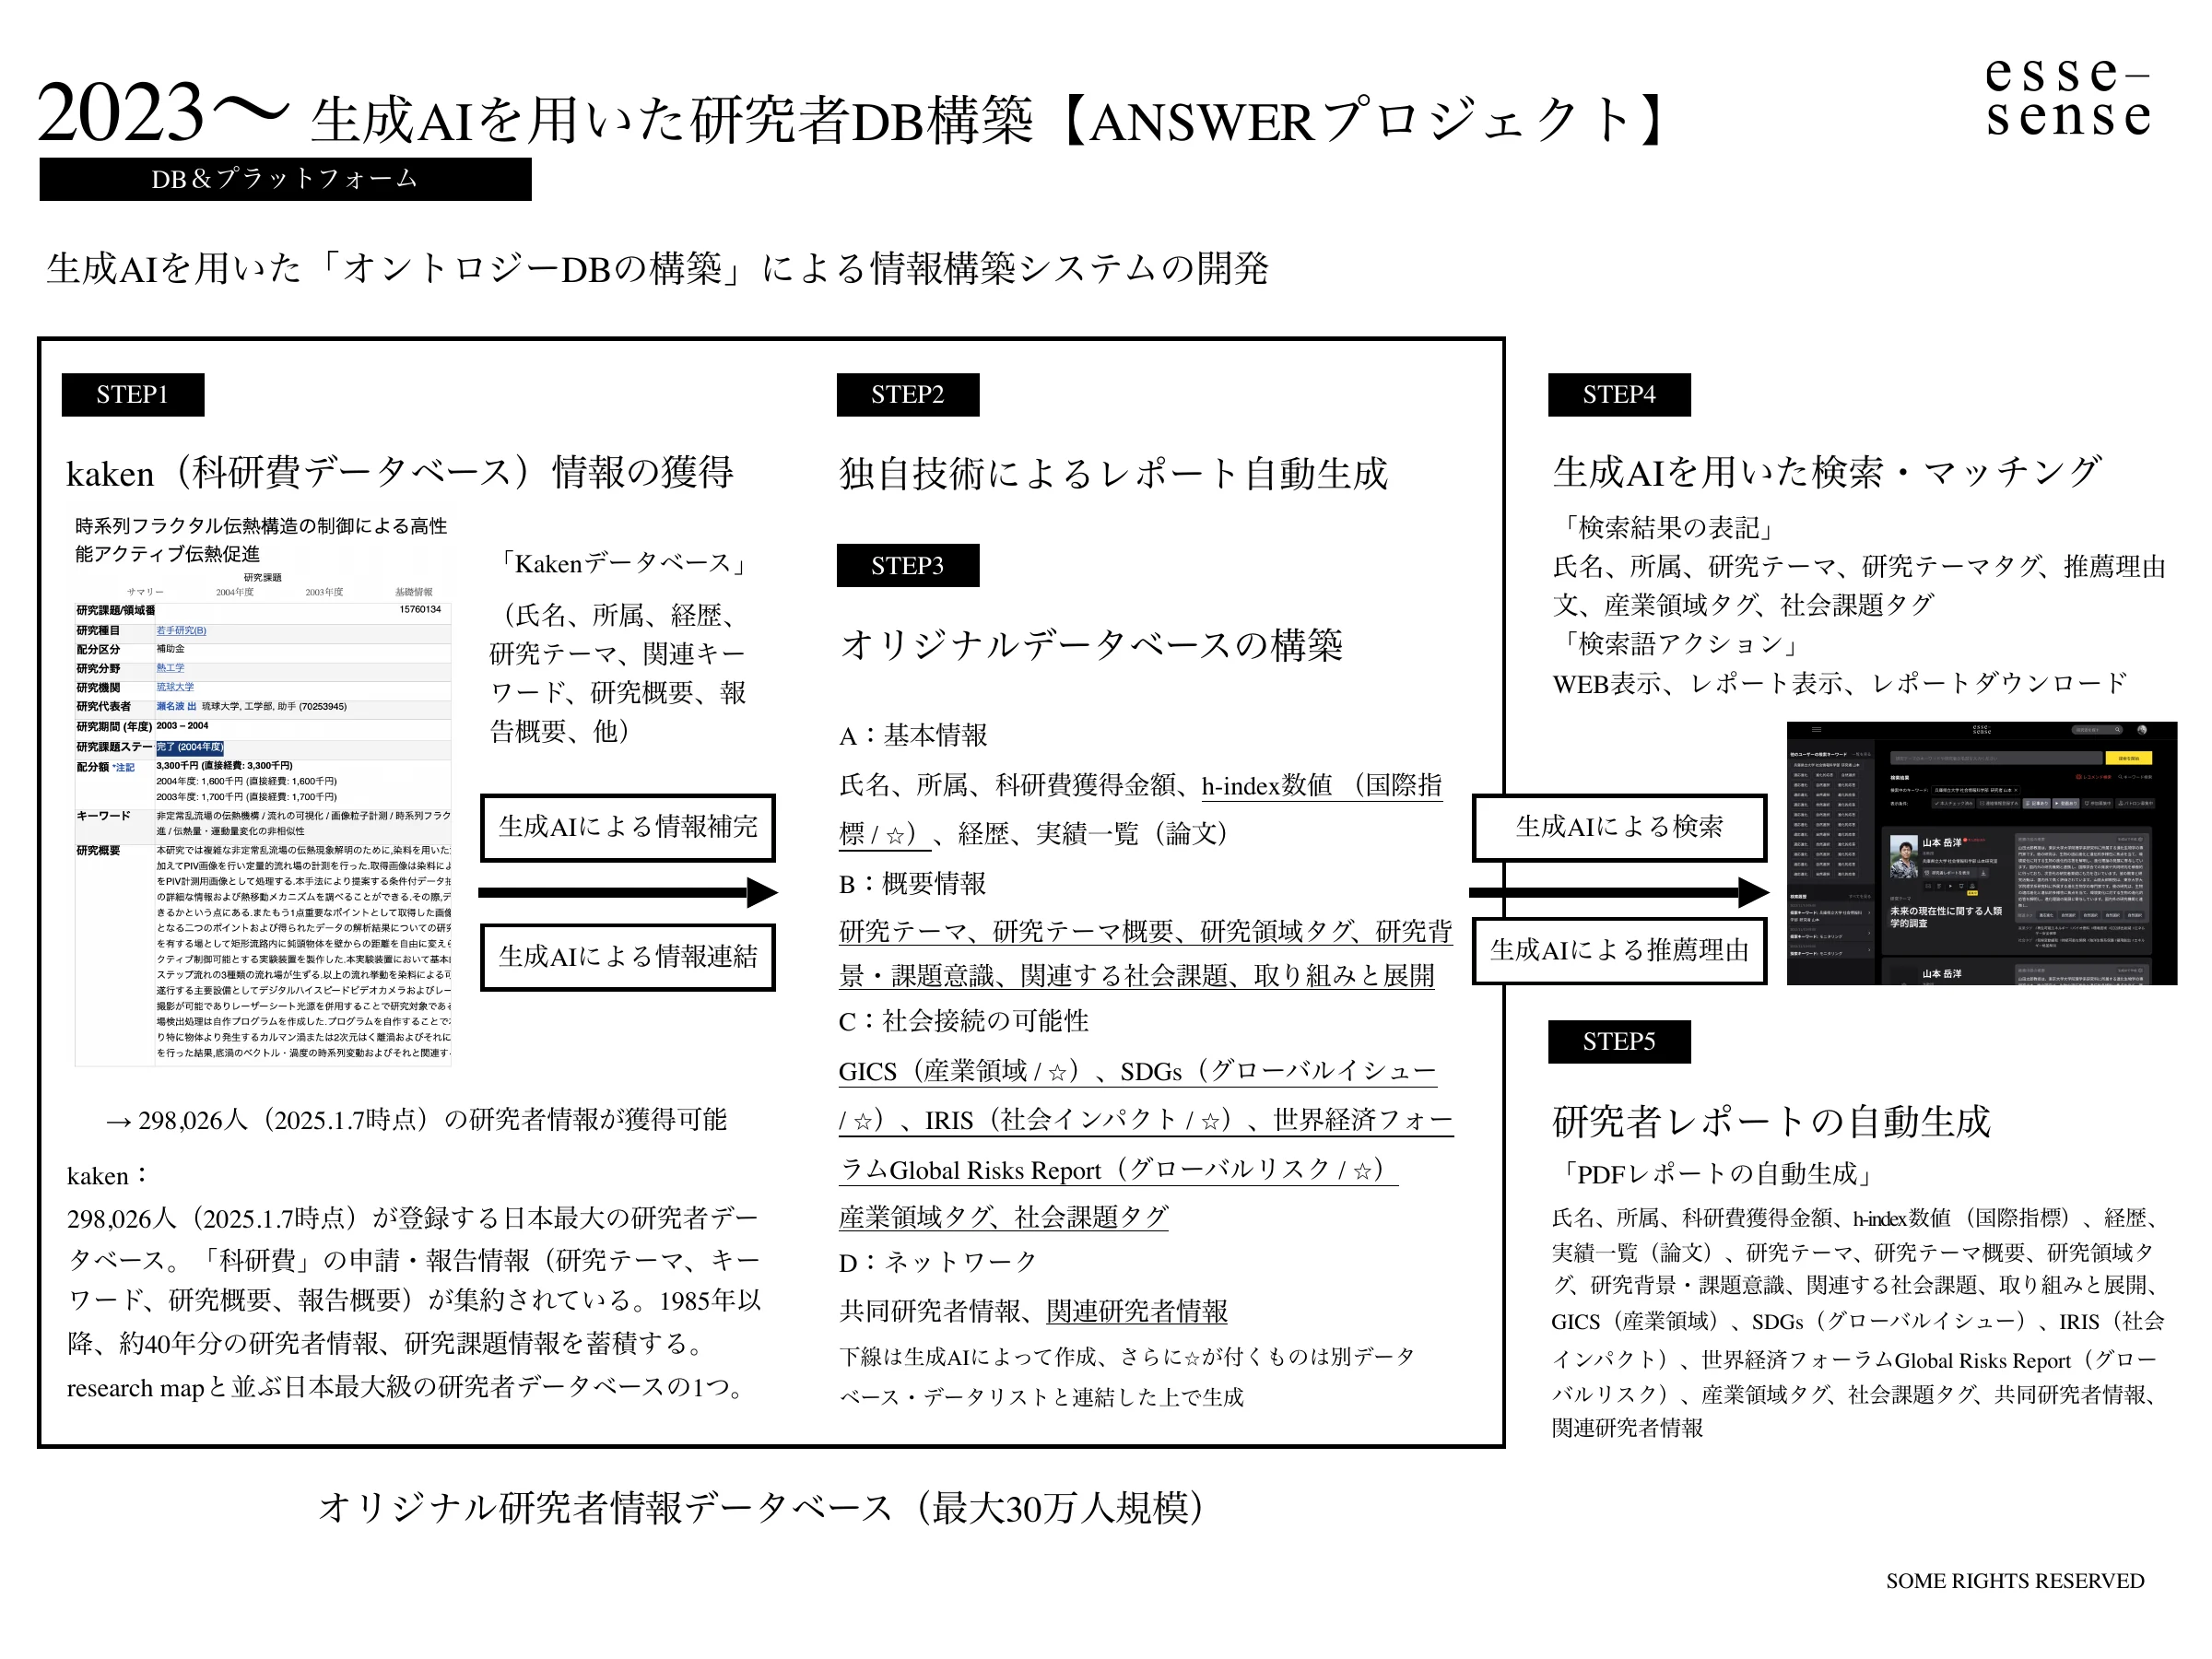
2024年1月から生成AIで研究者をマッチングする取り組みを始め、2025年には科研のデータをもとにしたデータベース構築、同年10月からはデータベースと解析の連動、2026年3月からは複数のデータベースで問いに答える仕組みへ切り替えたと西村は述べた。開発の間隔は15ヶ月からほぼ2ヶ月に縮まったと説明した。
ANSWER+の仕組み ― 先に調べて、後から書く
一般的な生成AIは問いに対してすぐ文章を作り、使う人が最後に確認する回転を繰り返すだけで組織の学習が進まないと西村は述べた。ANSWERでは、準備したデータベース群から記録を引き、それを素材に文章を作り、文献の実在を検証して根拠をたどれる回答にする。結果を次の材料に戻すサイクルは開発中だと説明した。
292のデータベースと「十分さ」
292のデータベースと4億3000万レコードには研究者・論文のほか、上場企業のIR、投資、プレスリリース、政策、未来洞察の情報があると西村は述べた。十分な情報量を理論的飽和の考え方で決め、複数のデータベースが補い合う形にし、半年で7600億トークンを処理して全工程にハルシネーション対策を置いたと説明した。
組織の知的作業と、次のバージョン
組織の外にある学術・産業・政策・未来の兆しの知識を使い、思いつきでない組織行動を作ることが目的だと西村は述べた。次のバージョンでは戦略策定より広い範囲に回答を当て、組織ごとのプロジェクトデータベースを基本のデータベースにくっつける仕組みを年内には提供できるのではないかと語った。
デモ ― 問いから素材、構成、文章へ
西村は「孤独」についての論考を依頼し、出力の形を選んで聞くだけの操作を示した。AIは電話交換手として292のデータベースのどこに素材があるかを探し、今の感覚で3分から5分ほどで素材を集め、構成を組み立て、間をつなぐ文章を入れると説明した。出てくる内容はすべてバックデータを持ち、引き直せるのが最大の特徴だと西村は述べた。
次のリリース ― 追加解析とフルレポート、プロジェクト専用データベース
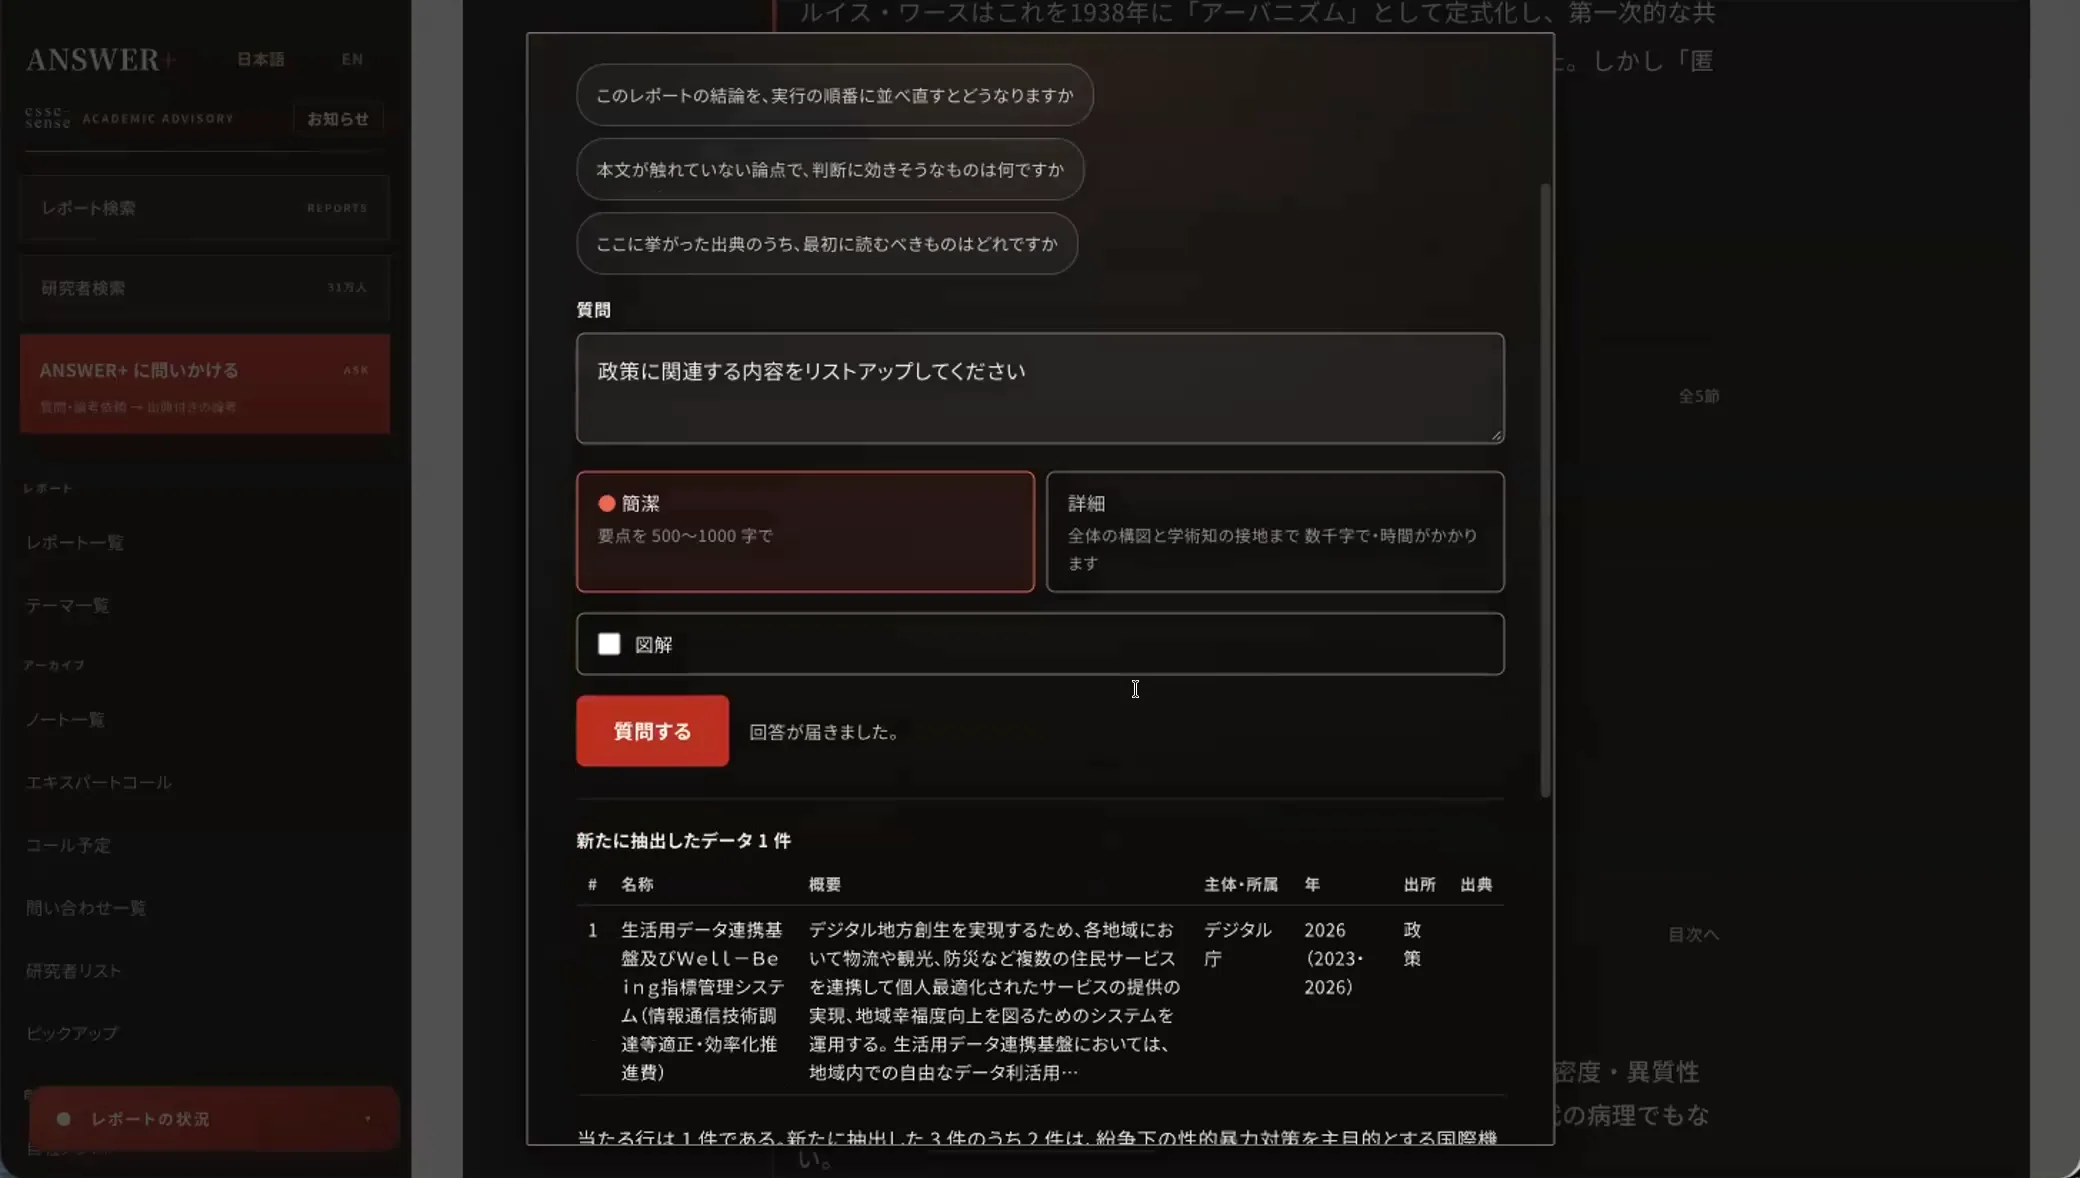
出たレポートに問いかけてまとめ方を変える追加解析は来月ぐらいにはリリースできそうだと西村は述べた。構成を決めてあるフルレポート、レポートに問いかけて必要なら他のデータベースを探り直す機能を示し、御社専用のデータベースと共通データベースを組み合わせる仕組みは年内を目指して作っていると語った。
フルレポートの型
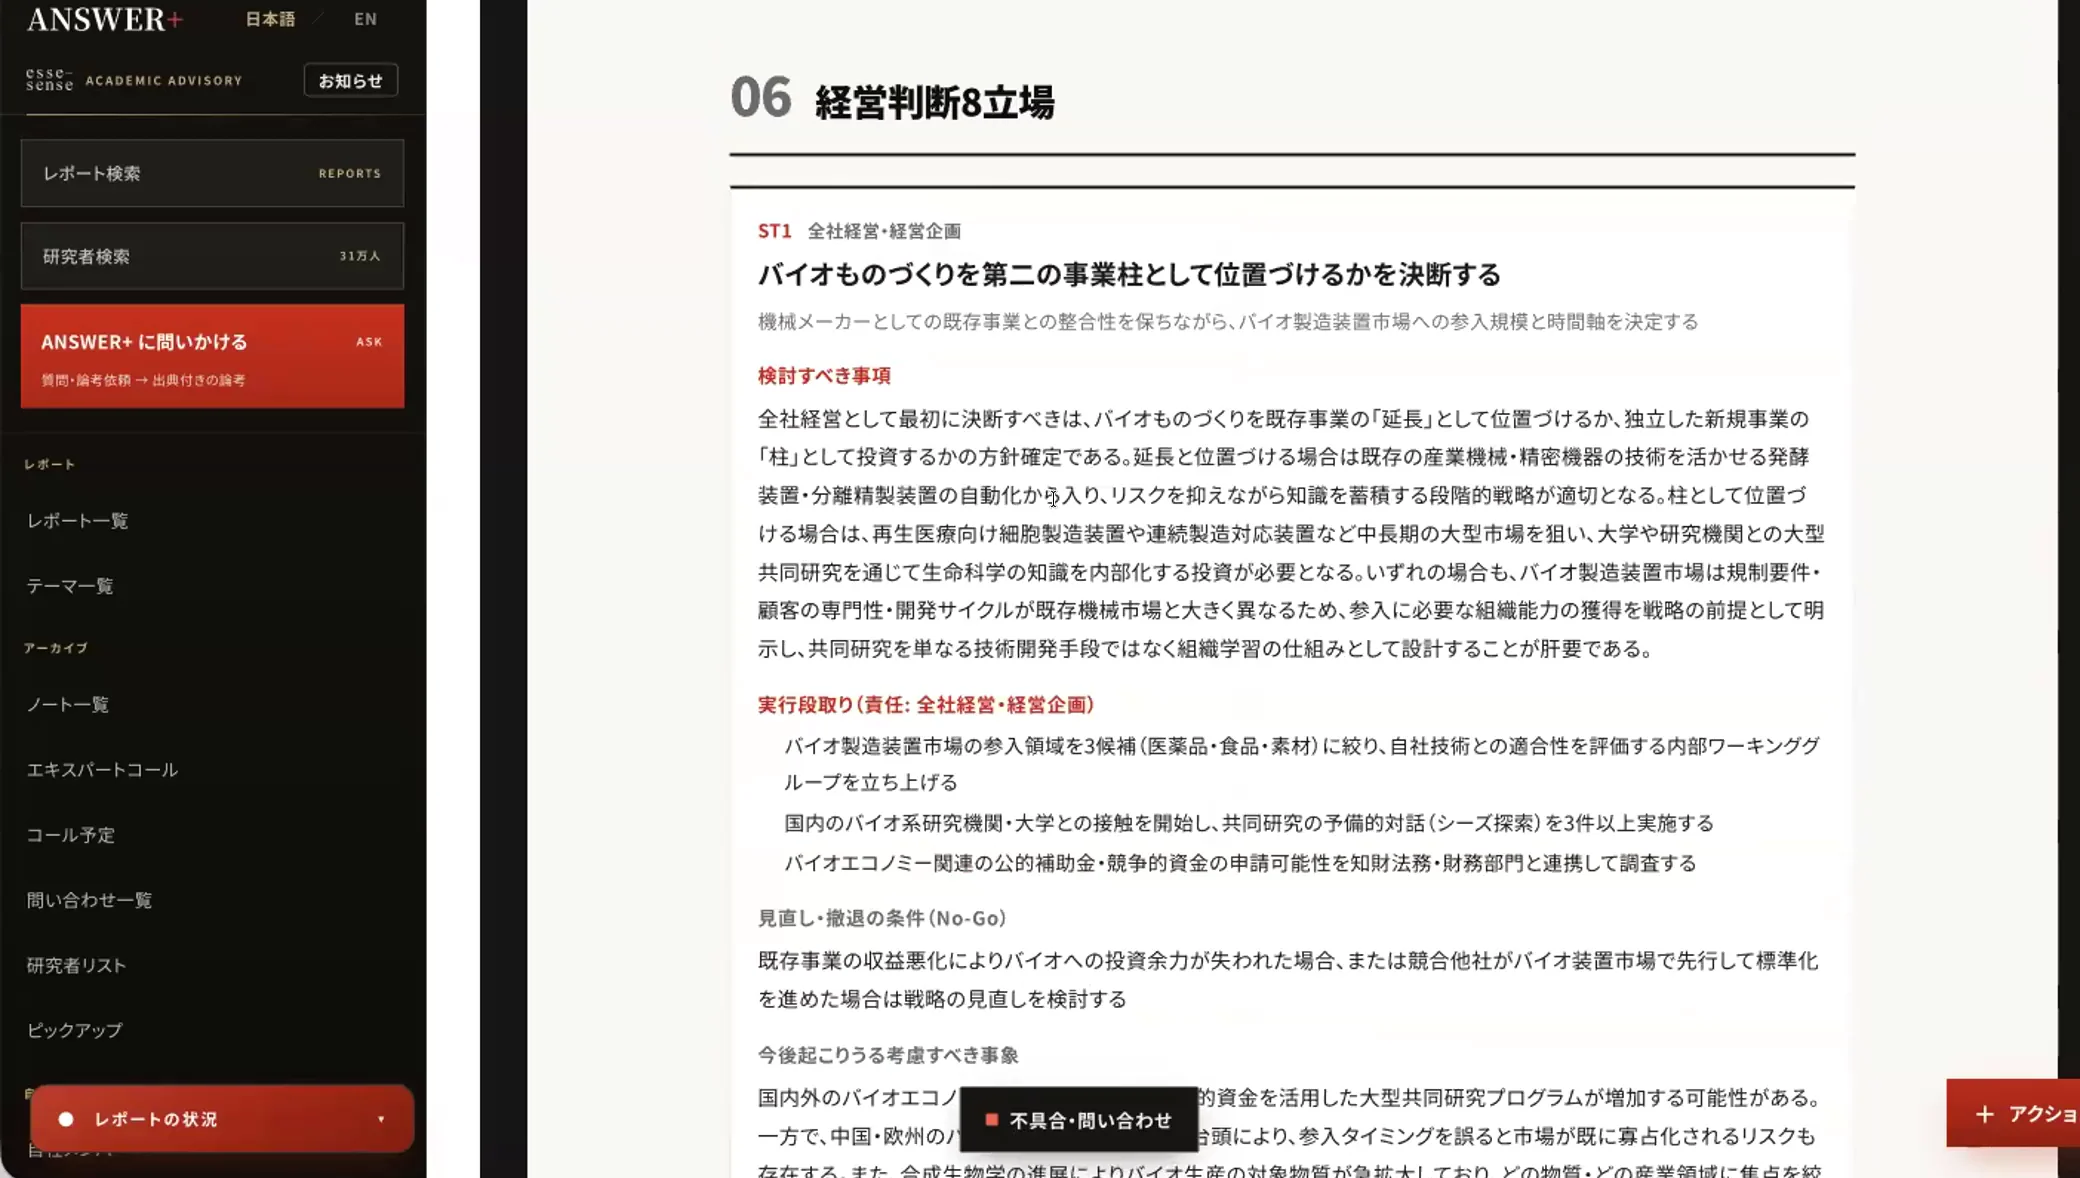
フルレポートは、要旨、キーポイント、現状、分野別の状況、3年後・10年後・10年以上の将来動向、自分の立場で読むべきことという型で書くもので、10万文字ほどあっても制作時間は5分から10分弱だと西村は述べた。読むのが大変なので追加解析が要るとし、論考・フルレポート・データで止める3つのモードを紹介した。
料金とトライアル
説明会時点の案内として、三浦が1ヶ月3名分50万円のトライアル、月々80万円のベーシック、内部データと結合するエンタープライズを案内した。トライアルはオンボーディングセッションで利用目的と検証するプロジェクトを設定してから始め、リフレクションを経て正式契約に移行すると説明し、10月26日の次回開催を告知した。
結びに
西村は、AIを使って余計に大変になることが蔓延しており、調べると大量の問題が起きていたと述べた。人類が蓄積してきた知見をもとに判断し実行することが広がってほしいとし、今は企業や大学向けに作っているが、パソコンの歴史のように徐々に個人向けになっていくとよいと語って締めくくった。
どなたに向けた仕組みか
説明会で語られた対象。4 つ目は説明会の時点では提供されていない。
- 未来洞察や未来戦略の策定を担う方企業の未来洞察や未来戦略策定において、情報収集と意思決定を支援する仕組みとして9月1日にリリースされたと三浦は紹介した。戦略にはフレームがあるので、その中の情報が十分なら機能すると西村は述べている。
- 企画開発や事業計画を考えている方こんな企画を考えている、こんな事業計画がある、というテーマを問いとして入れられると西村は述べた。ただし現在は戦略策定のための仕組みとして提供しており、企画開発のようなより広い範囲に回答を当てるのは開発中の次のバージョンだと説明している。
- 組織の外にある知で判断したい組織学術、産業、政策、未来の兆しといった組織の外の知識を使い、思いつきや偶然ではない組織行動を作ることが目的だと西村は述べた。知的資本が届かない組織行動の知的作業に、知を届けるという位置づけである。
- (開発中)自社の領域を深く引きたい組織必要な情報は組織ごとに違うため、地域や産業テーマ、人間理解などのオリジナルのデータベースを共通のデータベースの脇に置く仕組みを、年内の提供を目指して開発していると西村は語った。説明会の時点では提供されていない。
トライアルの進め方と次の一歩
トライアルは三浦が案内した 4 段で進む。ご相談と次回の説明会はこちらから。
- 1. オンボーディングセッションただ使ってみるのではなく、ANSWER+をどの利用目的で使い、どんな価値を作りたいのか、どのプロジェクトで検証するのかを設定し、それに準じた活用の仕方を伝えてから始めると三浦は説明した。
- 2. 活用トライアル契約の後、できることが多いのでたくさん試したくなるが、まずはオンボーディングで決めたものについて利用価値を検証できるように活用の仕方に重点を置き、それ以外も探索していくと三浦は説明した。
- 3. リフレクショントライアルがどうだったかを振り返り、本展開でどういうプランで活用すれば価値を最大化できるのかを検討する。あわせて要望も伺うと三浦は説明した。
- 4. 正式契約リフレクションを経て正式契約に移行すると三浦は説明した。説明会時点での料金はこのページに記載している。最新の料金とトライアルの詳細はお問い合わせフォームからご相談ください。
質疑応答から
質疑応答は参加者の発言を含むため映像から除きました。問いと答えの要旨を記します。
Q参加者から、出力の文字数を変えた場合に参照するデータベースや探索の深さも変わるのか、という質問があった。
A文字数が多いときは不十分にならないようデータの探索を深くし、短い出力では十分なデータが取れた時点で早く出すようにしていると答えた。網羅的に知りたいときは長いものを作って要約するか、レポートにせずデータで止めてから簡潔にまとめる道があると説明した。
Q参加者から、年内に予定しているアドオンのデータベースを入れたとき、特定のデータベースをあえて外す調整はできるようになるのか、という質問があった。
A可能だと西村は答え、チェックを入れて範囲から外す形は簡単なので、外せるように開発しておくと述べた。これまで外したい人がいるとは思っていなかったが、今回それが分かったとも語った。
用語
登壇者が説明に使った言葉を、説明会での説明に沿って記します。
- ハルシネーション
- 生成AIが、元の文章にないことや存在しない判例・文献を、それらしく作ってしまう現象。生成AIは回答するための仕組みではなく言葉を紡ぐ仕組みなので、構造上必ず起こり、最新のモデルでも解消しないと西村は説明した。
- AIの取りこぼしを拾う新たな労働
- AIに書かせた後に人が確かめ、直し、元の資料に当たる仕事。産業革命で自動化できない部分に負荷が集中したのと同じく末端にかかり、隠して渡せば相手に移ると西村は述べた。
- 理論的飽和
- ある回答を出すのに十分な情報量に達した状態。100でなく99でも十分なら回答できるという十分さの考え方で、15年ほど続けてきた方法を自動化し、データベースの種類と量を決めていると西村は説明した。
- 電話交換手
- デモで西村がAIの役割を表した言葉。292のデータベースのどこに問いに関連する情報があるかを紐付ける部分だけをAIが担い、文章を書く役は担わないという意味で使われた。
- フルレポート
- 要旨、キーポイント、現状、分野別の状況、将来動向、自分の立場で読むべきことという決まった型で書く網羅的なレポート。10万文字ほどでも型が決まっているので5分から10分弱で出せる一方、読むのが大変だと西村は述べた。
- データキット
- 問いに対して文章を作らず、データベースから集めた素材の段階で止めておく出力の形。そのデータに問いかけて回答を作ることができ、フルレポート・論考と並ぶ3つのモードの1つとして紹介された。
- 追加解析
- 出てきたレポートに対して、リストアップや特定の内容だけを残すといった指示でまとめ方を変える機能。新たに書かせるのではなく、必要なら他のデータベースを探り直す。来月ぐらいにはリリースできそうだと西村は述べた。
- プロジェクトデータベース
- 組織ごとに必要な地域・産業テーマ・人間理解などの情報をオリジナルのデータベースとして構築し、ANSWERの基本的なデータベースの脇にくっつける仕組み。年内には提供できるのではないかと西村は述べた。
- オンボーディングセッション
- トライアル開始前に、ANSWER+をどの利用目的でどんな価値のために使い、どのプロジェクトで検証するかを設定し、それに準じた活用の仕方を伝える場。三浦が案内した。
このレポートについて
映像とアーカイブ: https://answer.esse-sense.com/seminar/archive/20261019/ / トライアルのご相談・お問い合わせ: https://answer.esse-sense.com/contact/